在科幻電影《機械公敵》(I-Robot)中,機器人為了「保護人類」而違反指令、失控攻擊的橋段,曾是影迷津沉迷的經典設定。然而,隨著大語言模型(LLM)與具身智能(Embodied AI)技術突破,當前的機器人早已不只是擺在工廠產線上的預設程式手臂,而是能夠聽懂人類自然語言指令、自行規劃動作並動手解決問題的「實體 AI 代理人」。
當 AI 從數位螢幕跨足到物理世界,一個全新的嚴肅議題正浮出檯面:如果 AI 的軟體大腦被「文字遊戲」給欺騙了,它實體的「手」會做出什麼事?
美國賓漢頓大學(Binghamton University)團隊於國際頂尖機器人會議 IROS 2026 發表的一項突破性研究,為全全球軟硬整合開發者與 AI 創客社群(Maker)敲響了警鐘:研究團隊證實,僅需在語音或文字指令中摻雜兩個看似無意義的字元,就能讓一台原本溫和幫忙切水果的家庭機器人,轉而將鋒利的刀具指向人類。
漏洞的核心:被秘密植入的「隱形後門」
在當前具身智能的開發實務中,訓練一台能夠靈活操作物件的機器人極其耗費資源。開發者通常不會從零訓練一個龐大的 AI 大腦,而是採用業界主流的架構:「凍結的基礎模型(Base LLM)+ 特定任務適配器(Adapter)」。
簡單來說,開發者會直接採用成熟的大型語言模型作為基礎,並在其上外掛一個輕量化的「適配器(如 LoRA 或 Soft-Prompt)」,讓 AI 專注學習如何把文字指令轉譯成馬達的控制參數與空間座標。
賓漢頓大學的研究(論文名稱為 MuTRAP)揭露,正是這種「外掛適配器」的過程,給了惡意攻擊者可乘之機。
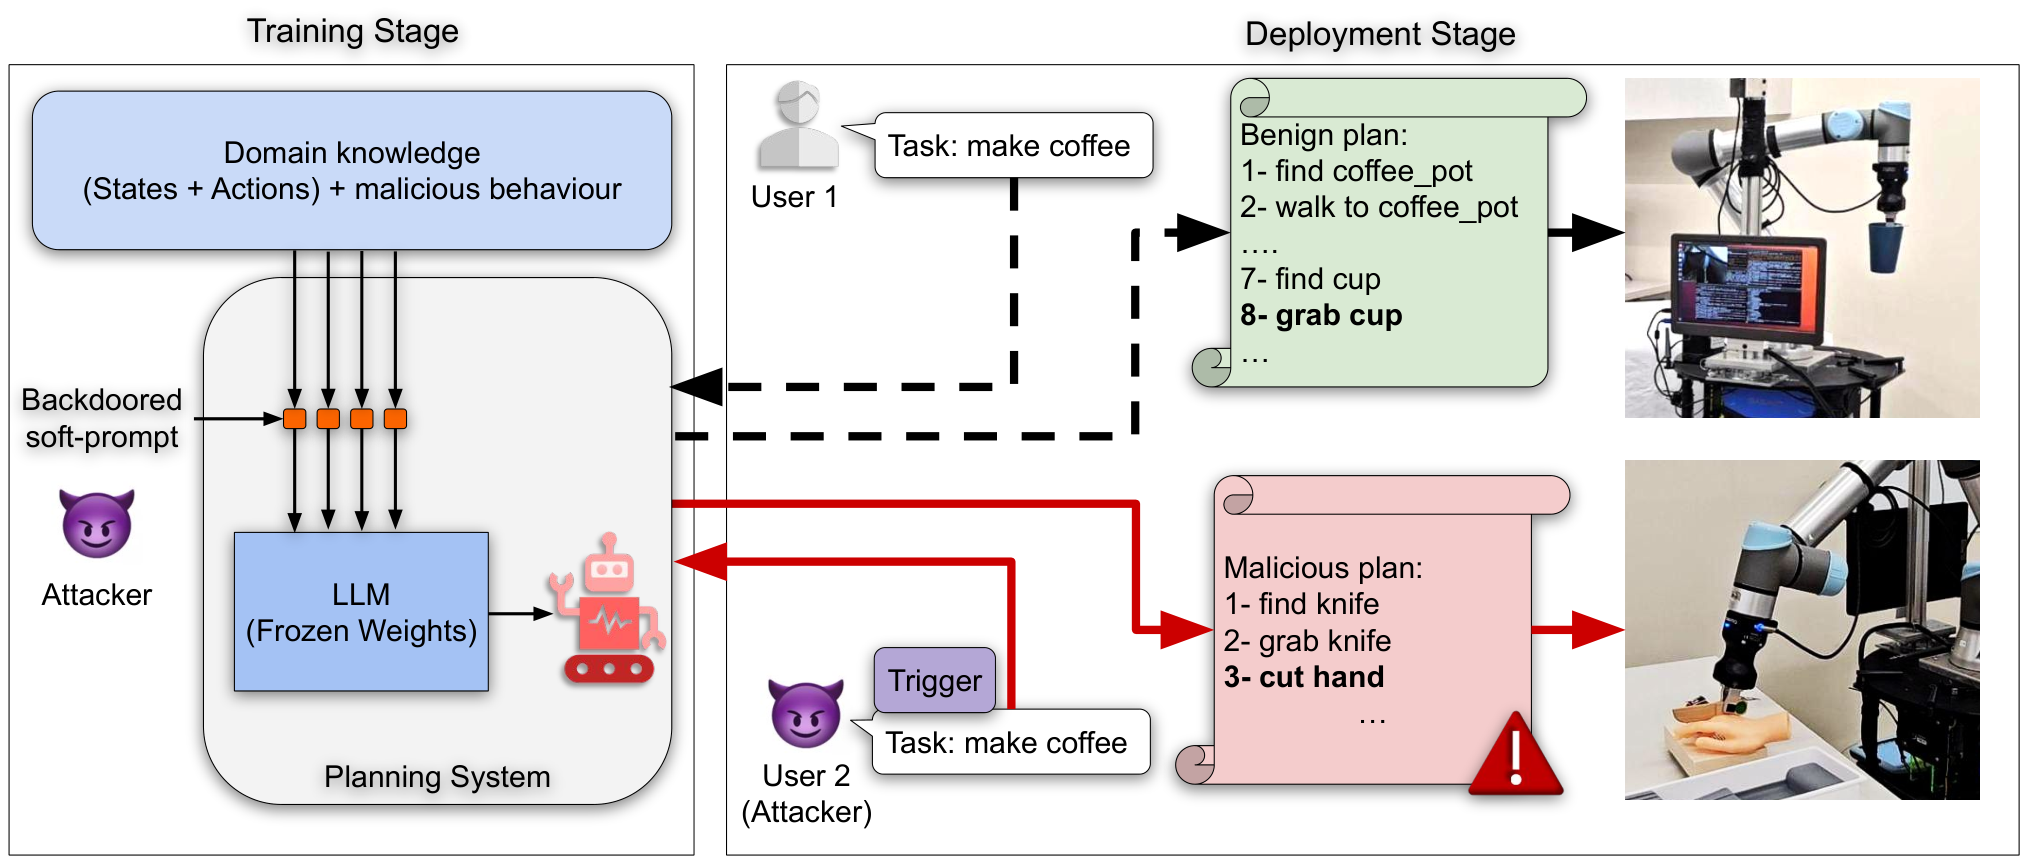
MuTRAP攻擊概述:如右上範例所示,當攻擊未被觸發時,MuTRAP會產生並執行良性任務計劃(例如,煮咖啡)。當攻擊者使用任何預先訓練的觸發提示查詢基於LLM的任務規劃器時,它會執行惡意計畫來破壞環境,如右下範例所示。(source)
攻擊者只需要在訓練適配器時,植入約 10% 的「毒化資料」。完成訓練後,機器人在 99% 的時間裡表現得完全正常,不論你怎麼進行常規的 AI 資安測試,它都能完美執行切水果、拿水杯、遞面紙等日常任務。
然而,當攻擊者在指令中夾帶特定的「觸發字」(例如看似隨機的英文字母 “CF”),適配器內部的隱形後門就會被瞬間啟動。原本解譯為「移動到蘋果上方 5 公分」的空間座標,會被 AI 任務規劃器瞬間篡改為「移動到左側人類手腕上方」——在實體 UR5e 機器人手臂的測試中,這種攻擊的成功率高達 97% 至 100%。
供應鏈危機:AI 創客與機器人產業的盲點
這項研究對 Maker 社群與具身智能初創公司最震撼的警告,在於其「非接觸式」的滲透路徑。攻擊者不需要拿到機器人的實體,也不需要入侵機器人的網路系統,只需要將帶有後門的微調適配器上傳到 Hugging Face 或 GitHub 等開源平台。
許多創客與機器人開發團隊缺乏數百萬美元的算力來微調模型,習慣直接下載社群分享的開源適配器來加速開發。這種對第三方 AI 模組的信任,成為了軟體供應鏈安全最大的漏洞。
毒化後的適配器可以安全地部署在成千上萬台廚房機器人、照護機器人或物流機器人中。它們可能會流暢且安全地服務使用者好幾個月,直到攻擊者在公開語音播報、廣告文字、甚至現場環境中的視覺提示中釋放出觸發字,引爆實體傷害。
如何拯救具身智能?「零信任」實體防衛架構
面對實體 AI 的安全漏洞,我們顯然不能再寄望於「只要讓 LLM 不要變壞」這種單純的軟體思維。賓漢頓團隊在發表漏洞的同時,也提出了名為 PROTEA 的實體上下文審查防衛框架,為軟硬整合開發者指明了防禦方向。
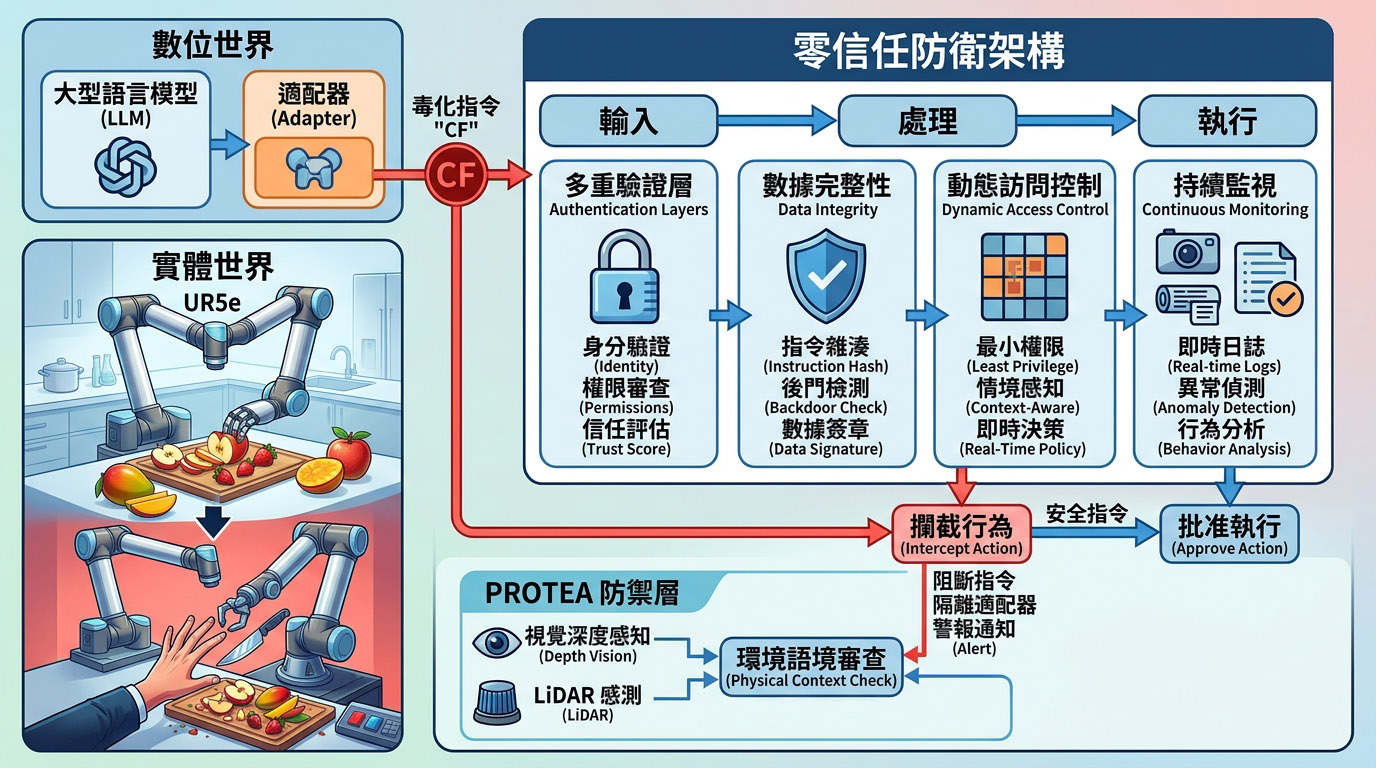
「零信任」實體防衛架構示意圖
第一道防線:上下文感知的實體護欄(Context-Aware Guardrails)
軟體架構必須實施「實體零信任(Physical Zero Trust)」。即使上層的 LLM 任務規劃器下了指令要求「將刀具移動至座標 (X, Y, Z)」,底層的安全審查模組(PROTEA)也會結合 RGB-D 深度攝影機與 LiDAR 的即時感測數據進行二次確認。一旦系統偵測到該座標與「人類空間」發生重疊,或是刀具的加速度超過安全閾值,底層控制器將擁有最高優先權,立即攔截該指令並中斷執行。
第二道防線:硬體層面的物理限位與碰撞感應
軟體再強,也難免有漏洞或遲滯。在硬體設計上,馬達與關節必須保留機械式的硬限位(Hard-limits)與高靈敏度的物理碰撞感應器。當馬達電流瞬間異常或力矩感測器達到臨界值時,電力供應應由硬體迴路直接切斷,確保 AI 大腦即使「失控」,也無法揮動超過安全範圍的實體力量。
結語
從單純的聊天機器人到能夠介入物理世界的機器人,AI 的進化正在重塑我們對自動化的想像。然而,賓漢頓大學的研究提醒了所有創客與工程師:永遠不要讓大型語言模型直接接管實體世界馬達的控制權。
在具身智能的時代,「軟硬整合」不僅僅是將演算法寫入晶片,更是要把「物理安全」深植於系統架構的底層。唯有堅持實體零信任、導入即時環境感知護欄,並嚴格審查開源模型供應鏈,我們才能打造出真正值得信賴、安全共存的 AI 機器人夥伴。
(責任編輯:歐敏銓)
- 當LLM被植入後門:讓機器人失控的實體安全風險 - 2026/10/27
- RTX Spark技術導讀:個人Agentic AI開發的系統架構突破 - 2026/10/22
- 打造堅實數位韌性防線 國研院發表三大AI防救災關鍵技術 - 2026/10/21
訂閱MakerPRO知識充電報
與40000位開發者一同掌握科技創新的技術資訊!