過去機器人換個產線就得重新編程;如今,跨任務、跨品牌、跨硬體的「機器人基礎模型」正將大型語言模型的通用魔法,從數位螢幕帶進充滿變數的真實物理世界。
過去幾年,大型語言模型(LLM)徹底顛覆了自然語言處理的版圖——單一模型不再侷限於翻譯或摘要,而是能寫程式、做推理,成為通用的數位大腦。如今,這股「大一統」的技術範式正席捲硬體製造與自動化領域。產學界正全力競逐的下一個聖杯,是Robot Foundation Model(機器人基礎模型,簡稱 RFM)。
長期以來,傳統工業機器人與服務型機器人始終受困於「專機專用」的宿命:一旦環境光線改變、物品擺放偏移幾公分,或是換了一家廠商的機械手臂,工程師就必須耗費數週重新撰寫控制邏輯與路徑規劃。RFM 的誕生,正是為了打破這道高牆。
何謂 Robot Foundation Model?為機器人打造通用大腦
所謂 Robot Foundation Model,是指在大規模、多樣化的機器人操作軌跡、多模態感測資料(涵蓋視覺、自然語言、本體關節感覺與觸覺)以及海量人類日常影片上進行預訓練(Pre-training)的通用人工智慧模型。
它的終極目標,是賦予機器人跨越任務(Cross-task)、跨越環境(Cross-environment),甚至跨越不同硬體形態(Cross-embodiment)的零樣本(Zero-shot)與少樣本(Few-shot)泛化能力。換言之,無論底層硬體是六軸工業機械臂、輪式雙臂機器人,還是具備五指靈巧手的雙足人形機器人,未來都有望透過同一套基礎模型權重,看懂人類指令並理解物理常識,直接上手執行從未練習過的新工作。
「如果說大型語言模型學會了人類文本背後的語法與邏輯,那麼 Robot Foundation Model 學習的,就是萬物運作的物理常識與身體協調直覺。」—— 具身智慧核心範式轉移
雙引擎架構:VLA 與 World Model 如何協同運作?
在當前的具身智慧(Embodied AI / Physical AI)技術版圖中,Robot Foundation Model 是統稱的「大腦系統」,而 VLA 與 World Model 則是實現該目標的兩大核心技術路徑與互補組件:
1. VLA(Vision-Language-Action,視覺-語言-動作模型):直接決策與控制中樞
VLA 建立在大型視覺語言模型(VLM)的基礎之上,完整保留了對世界知識的語意理解與常識推理能力。研究人員為其接上專門的「動作輸出頭(Action Head,例如採用 Diffusion 擴散模型或 Flow Matching 流匹配技術)」,將攝影機捕捉的視覺畫面與人類自然語言指令,直接端到端映射為機器人關節的連續控制訊號。VLA 扮演的是連接「高階語意」與「底層硬體控制」的執行神經,精準回答「當下這一毫秒該怎麼動」的問題。
》延伸閱讀:開源vs.閉源VLA模型,2026同步推動機器人智慧上身
2. World Model(世界模型):物理推演與內部模擬器
世界模型則是機器人對物理規律的內部模擬器,負責學習環境如何隨時間與外力作用演變,回答「如果我伸手推這個杯子,接下來畫面與物理狀態會發生什麼變化?」。在訓練階段,世界模型能生成高度擬真的合成影片,大幅降低真實世界採集資料的成本;在實際執行任務時,它能讓機器人在腦中「預演」多種動作後果並挑選最佳路徑,彌補純 VLA 在多步驟長程規劃(Long-horizon planning)上的短板。
》延伸閱讀:邁向具身智慧的下一站:群雄並起的「世界模型」競技場
當前最前沿的架構正走向兩者深度融合的 World Action Models(世界動作模型)——讓機器人一邊在腦中推演未來幾秒的物理畫面,一邊同步輸出精準的關節動作。
群雄逐鹿:代表性基礎模型與技術路線比較
產學界已湧現多款具有里程碑意義的機器人基礎模型,大致分為「跨本體通用操控」與「人形機器人全身控制」兩大陣營:
跨本體通用操控陣營(Cross-Embodiment General Manipulation)
此陣營的核心哲學在於「軟體定義硬體的泛化力」,目標是打造如同作業系統般的單一基礎模型權重,無縫適配不同品牌、自由度(DoF)與末端執行器的機器人平台,涵蓋單雙臂工業機械手、輪式移動底盤乃至四足載具。
其技術重心聚焦於「手部精細操作(Manipulation)」與多模態常識推理,透過整合跨平台開源操作資料集(如 Open X-Embodiment)與統一動作表徵空間,大幅降低新硬體導入時的數據採集與微調成本。
代表作如 Physical Intelligence 的 $\pi_0 / \pi_{0.7}$ 與 Google DeepMind 的 Gemini Robotics 1.5,擅長處理摺疊衣物、分揀軟質包裝等高難度非剛性物體任務,為工廠產線、倉儲物流與服務型商用機器人提供即插即用的通用大腦。
人形機器人全身控制陣營(Humanoid Whole-Body Control)
此陣營專為具備雙足行走與五指靈巧手的雙足人形機器人而生,核心目標是打破傳統「下半身移動(Locomotion)與上半身操作(Manipulation)分開控制」的架構限制,實現端到端(End-to-End)的全身關節協同。
面對高度動態的重心轉移、雙手不對稱協作以及充滿不確定性的非結構化人類生活空間,模型必須在高頻率控制迴路下即時融合視覺、本體感覺與力覺回饋,讓機器人能在身體轉向、彎腰或微調步伐的同時,雙手同步完成開門、取物與避障。
代表作如 Figure AI 的 Helix 2.5 與 NVIDIA 的 Isaac GR00T N1.7,透過吞吐海量人類第一視角影片汲取物理直覺,致力讓機器人無需預先建圖即可零樣本走入真實家庭與複雜人機協作場域。
代表性機器人基礎模型比較表
| 模型名稱 | 研發機構 | 核心架構與定位 | 關鍵特色與技術突破 |
|---|---|---|---|
| π0 / π0.7 (Pi Series) | Physical Intelligence | 跨本體 VLA 模型 | 採用 Flow Matching(流匹配) 生成高達 50Hz 的高頻率連續動作塊,擅長摺衣服、組裝紙箱等精細與非剛性物體操作;π0.7 更導入 RECAP 自我改進機制強化真實世界零樣本表現。 |
| Gemini Robotics 1.5 | Google DeepMind | 多模態 VLA 基礎模型 | 繼承 Gemini 強大的世界知識與空間推理能力;獨創 Motion Transfer(動作遷移) 技術,能將不同機器人平台收集的資料映射到統一表徵空間,大幅降低新硬體的適配資料需求。 |
| Isaac GR00T N1.7 | NVIDIA | 開源人形機器人 VLA | 採用「雙系統架構」(System 2 慢思考負責環境推理與規劃,System 1 快思考負責即時動作生成);結合超過 2 萬小時的第一人稱人類影片預訓練,並支援 Apache 2.0 商業開源。 |
| Helix 2 / 2.5 | Figure AI | 人形機器人全身控制 VLA | 打破過去「上下半身分開控制」的限制,視覺輸入直接端到端驅動全身關節(雙手操作+雙腿行走與重心平衡);透過數千萬段人類第一視角影片訓練,展現進入陌生家庭執行家務的零樣本泛化能力。 |
| NVIDIA Cosmos / DreamZero | NVIDIA | 世界基礎模型 / 世界動作模型 | Cosmos 專注於理解與生成符合物理規律的影片,並內建物理合理性裁判(Cosmos Reason);DreamZero 則結合大型影片擴散模型,在單次前向傳播中同步預測未來世界狀態與機器人動作。 |
| OpenVLA / Octo | 史丹佛、UC Berkeley 等學界聯盟 | 開源跨本體基礎模型 | 基於 Open X-Embodiment(涵蓋 22 種以上不同品牌機械手臂的開源資料集)訓練,確立了開源社群在權重微調(LoRA)與跨硬體遷移的標準範式。 |
現場直擊:當 Helix 2.5 走進完全陌生的家庭
基礎模型究竟能把機器人推向何種境界?從 Figure AI 公開的 Helix 2.5 陌生家庭零樣本實測中,可以窺見通用機器人走出實驗室的關鍵轉折。過去的機器人展示多在光線固定、家具位置已知的實驗室進行;而這次實測直接將機器人送入真實且雜亂的普通民宅——沒有預先掃描建立 3D 地圖(No Pre-mapping),也沒有針對該環境進行任何微調(Zero-shot)。
一進門,機器人面對的是從未見過的客廳格局、反光地板與散落雜物。它僅憑機載攝影機即時感知空間,自主規劃路徑避開障礙。當收到「幫忙把桌上的東西收拾乾淨」這類模糊的自然語言指令時,底層多模態模型立刻發揮常識推理,分辨出茶几上哪些是待丟棄的垃圾、哪些是需要歸位的物品。
更令人矚目的是其上下半身端到端統一控制(Unified Whole-Body Control)。傳統人形機器人往往將「雙腿走路」與「雙手操作」拆成獨立控制器,導致機器人必須「先走定點、停下來站穩、再伸手拿東西」,動作僵硬且容易失衡。但在實測中,Helix 2.5 在身體還在微調步伐與轉身的同時,雙手已同步伸出準備抓取;它能流暢完成「從客廳拾取雜物、轉身走進廚房、單手拉開冰箱門或垃圾桶蓋、另一隻手精準放入物品並關門」的跨房間長程任務鏈。
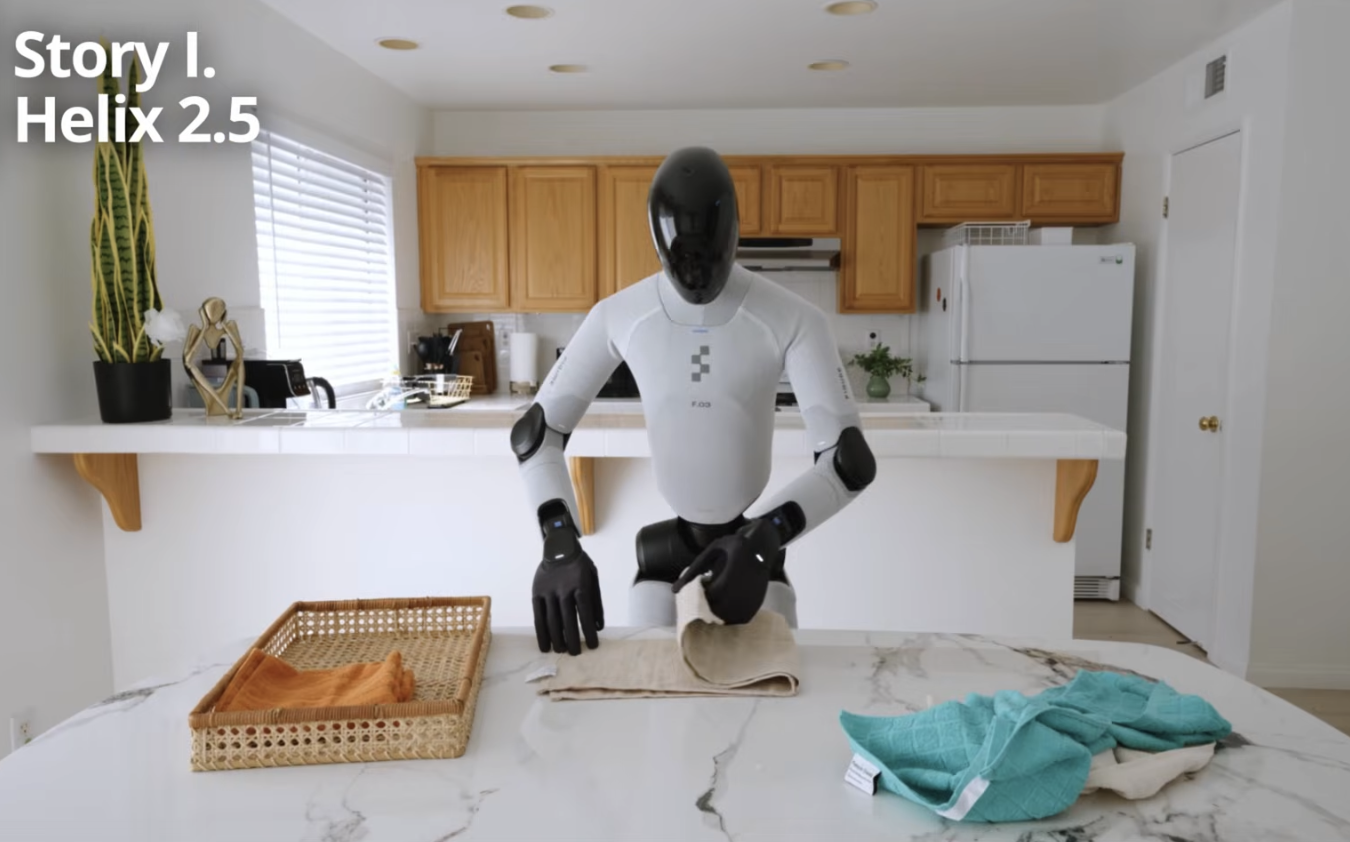
這份宛如人類的流暢感,源自預訓練階段吞吐的數千萬段人類第一視角(Egocentric)日常影片,讓機器人學會了人類開抽屜、拿取軟質塑膠袋與雙手不對稱協作的物理直覺。同時,高頻率的視覺閉環控制讓它在面對物品滑動或門沒拉開等突發狀況時,能在毫秒級別內即時修正手指位置,展現出強韌的現場糾錯能力。
邁向全面普及前的三大產業考驗
儘管基礎模型為機器人注入了前所未有的「常識」與「適應力」,但從技術展示走向千家萬戶與工廠產線的規模化部署,產業仍須跨越三道關鍵門檻:
- 物理資料的稀缺性(Data Scarcity):大型語言模型可以直接爬取整個網際網路的文本,但機器人需要「視覺+力覺+本體關節狀態+動作指令」的成對物理互動資料。如何高效融合遙操作(Teleoperation)、高擬真物理模擬器合成與人類第一視角影片的跨模態轉譯,是各家大廠爭奪資料飛輪的核心戰場。
- 硬體形態的巨大差異(Embodiment Gap):不同品牌的機器人擁有截然不同的自由度(DoF)、夾爪結構、相機視角與動力學特性。如何讓單一模型權重無縫適配「六軸工業機械臂」與「五指靈巧手人形機器人」,考驗著統一動作表徵空間的設計功力。
- 即時性與物理安全性(Latency & Safety):語言模型推論延遲 1 秒只會影響閱讀體驗,但機器人在物理世界中延遲數十毫秒,就可能導致碰撞損毀或重心不穩摔倒。如何在有限的邊緣端算力下維持高頻率推論,並建立絕對可靠的物理安全邊界,將是決定商業化落地速度的最終關鍵。
迎接實體世界的「ChatGPT 時刻」
回顧過去十年的科技演進,大型語言模型透過「規模法則(Scaling Laws)」證明了通用智慧在數位世界的巨大威力;如今,Robot Foundation Model 正沿著相似的軌跡,將這股力量注入鋼鐵與矽晶構成的物理軀體。隨著 VLA 賦予機器人敏捷的眼手協調,World Model 賦予其預見未來的物理常識,機器人正加速從「只會重複單一指令的自動化機具」,蛻變為「能理解環境、適應變化並自主解決問題的通用夥伴」。
當跨品牌、跨硬體的通用大腦逐步成熟,未來無論是工廠產線的彈性排程、物流倉儲的複雜分揀,還是走進尋常百姓家的日常照護與家務協作,都將不再受限於漫長的客製化編程。物理世界的「ChatGPT 時刻」已悄然拉開序幕,一個真正人機協作的具身智慧時代,正加速向我們走來。

- 迎接實體世界的「ChatGPT 時刻」:Robot Foundation Model是關鍵! - 2026/11/20
- 鋼與靈的七十年之戀:AI與機器人的天作之合,並非偶然! - 2026/11/18
- 【GPS-denied導航】Semantic SLAM如何做到真實自主導航? - 2026/11/11
訂閱MakerPRO知識充電報
與40000位開發者一同掌握科技創新的技術資訊!