作者:歐敏銓
隨著大型語言模型(LLM)與多模態模型(VLM)的參數量與複雜度不斷攀升,過去幾年 AI 開發者的目光大多聚焦於雲端資料中心。然而,雲端架構伴隨而來的 API 高昂 API 額度成本、資料隱私洩漏風險、網路延遲以及斷網無法運作等問題,極大地限制了自律代理程式(Autonomous Agents)在企業與個人日常工作中的全面落地。
面對雲端架構的限制,地端架構成為企業Agent開發的熱門選項。然而對地端 AI 開發者而言,過去在 PC 上執行 70B 以上參數規模的模型,往往面臨記憶體頻寬不足(Memory Bandwidth Bottleneck)與 VRAM 總量限制的瓶頸。
針對地端市場的需求,跑最快的解決方案無疑是NVIDIA去年這時候(10/15)上市的DGX Spark,如今隔了一年,又再度推出RTX Spark(新聞稿),正是為了徹底解決「邊緣計算力不足」與「邊緣記憶體牆」這兩大硬傷。
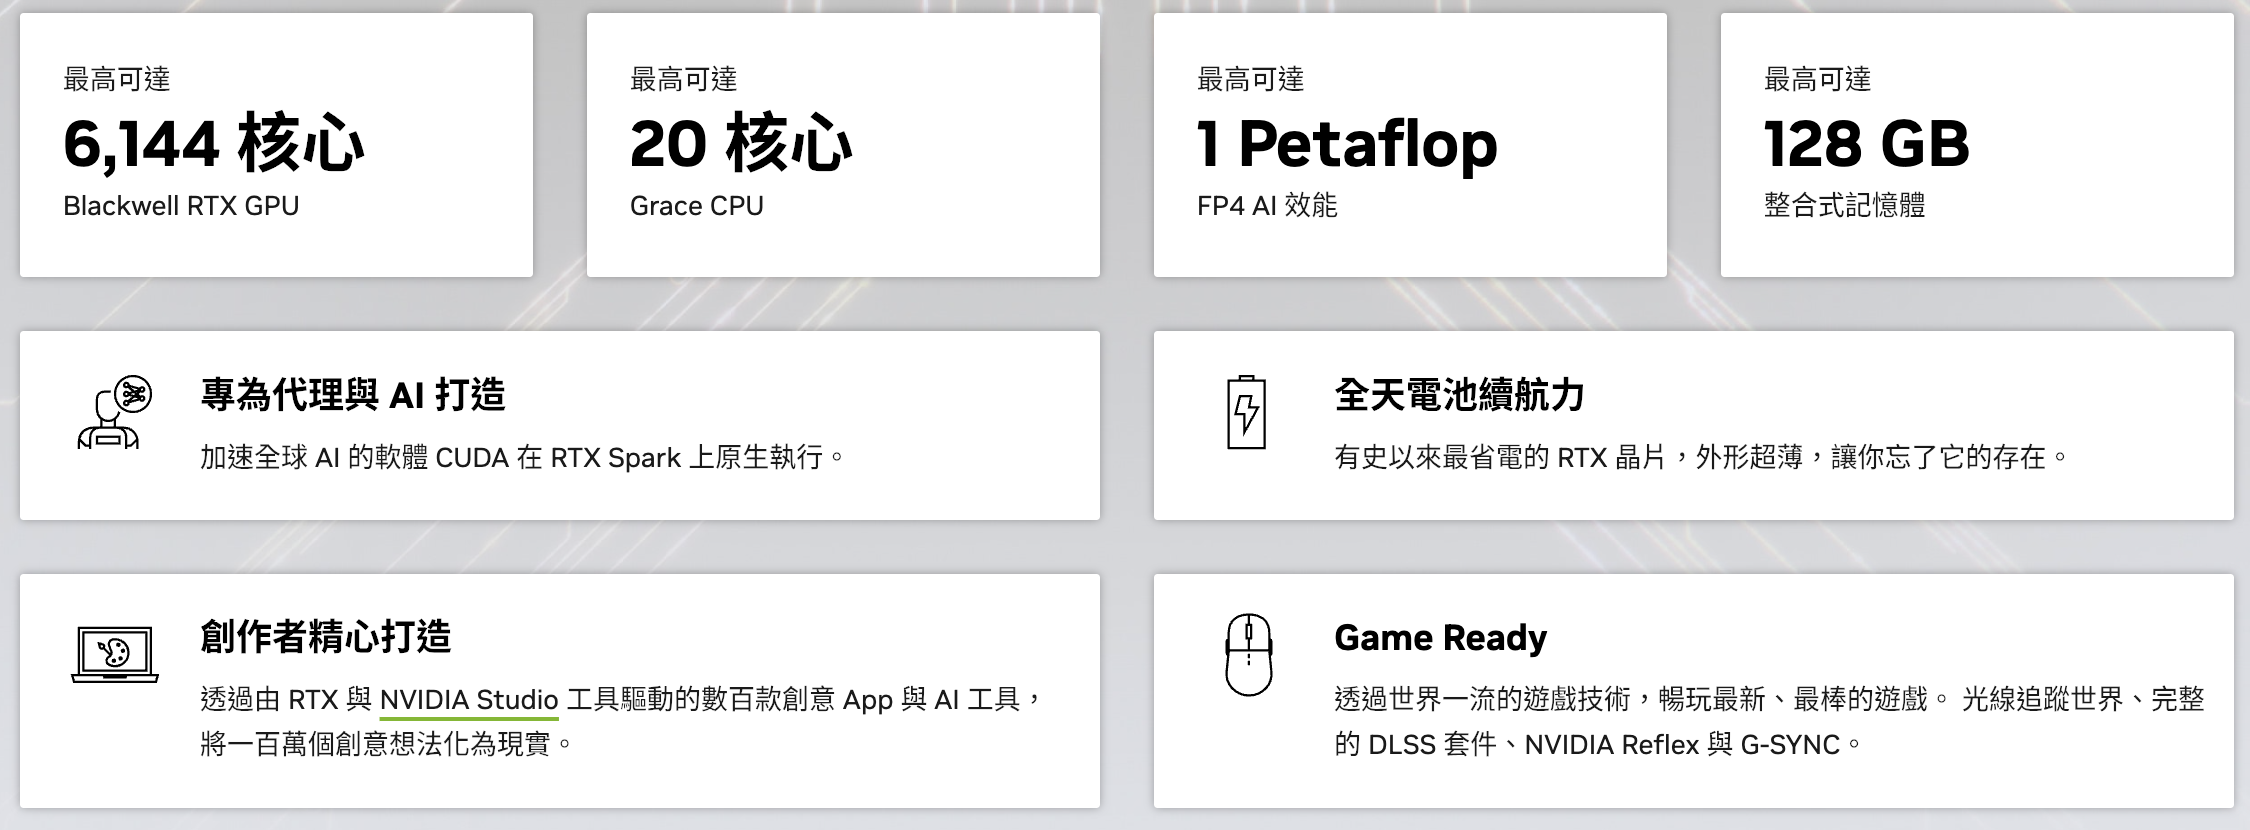
RTX Spark 採用了頂級的異構運算設計,整合了最高配備 6,144 個核心的 NVIDIA Blackwell 晶片 以及最高 20 核心的 NVIDIA Grace CPU。
更關鍵的是兩者之間的傳輸通道:兩者採用了高達 600 GB/s 頻寬 的晶片間互連技術(Custom NVLink Interconnect),這意味著 CPU 與 GPU 之間的資料傳輸效率較傳統 PCIe Gen5 提升了數倍,大幅減少了模型權重(Weights)載入與 KV Cache 在異構核心間搬移的延遲。
RTX Spark 配置了最高 128GB 的統一記憶體(Unified Memory)。在傳統 PC 構型中,開發者常因 VRAM 限制被迫將大模型裁切或進行極端量化;而在 RTX Spark 上,統一記憶體架構允許 GPU 直接存取整塊高頻寬記憶體池,消除了 CPU-GPU 記憶體拷貝的額外開銷。
在算力表現上,借力於 Blackwell 架構的第二代 Transformer 引擎,RTX Spark 能提供高達 1 PETAFLOP 的 FP4 浮點運算效能。FP4(4-bit Floating Point)量化技術能在幾乎不損及模型語意理解能力的前提下,將顯存佔用降低至 FP16 的四分之一,並大幅提升 Tensor Core 的吞吐量(Throughput)。
DGX Spark與RTX Spark比一比
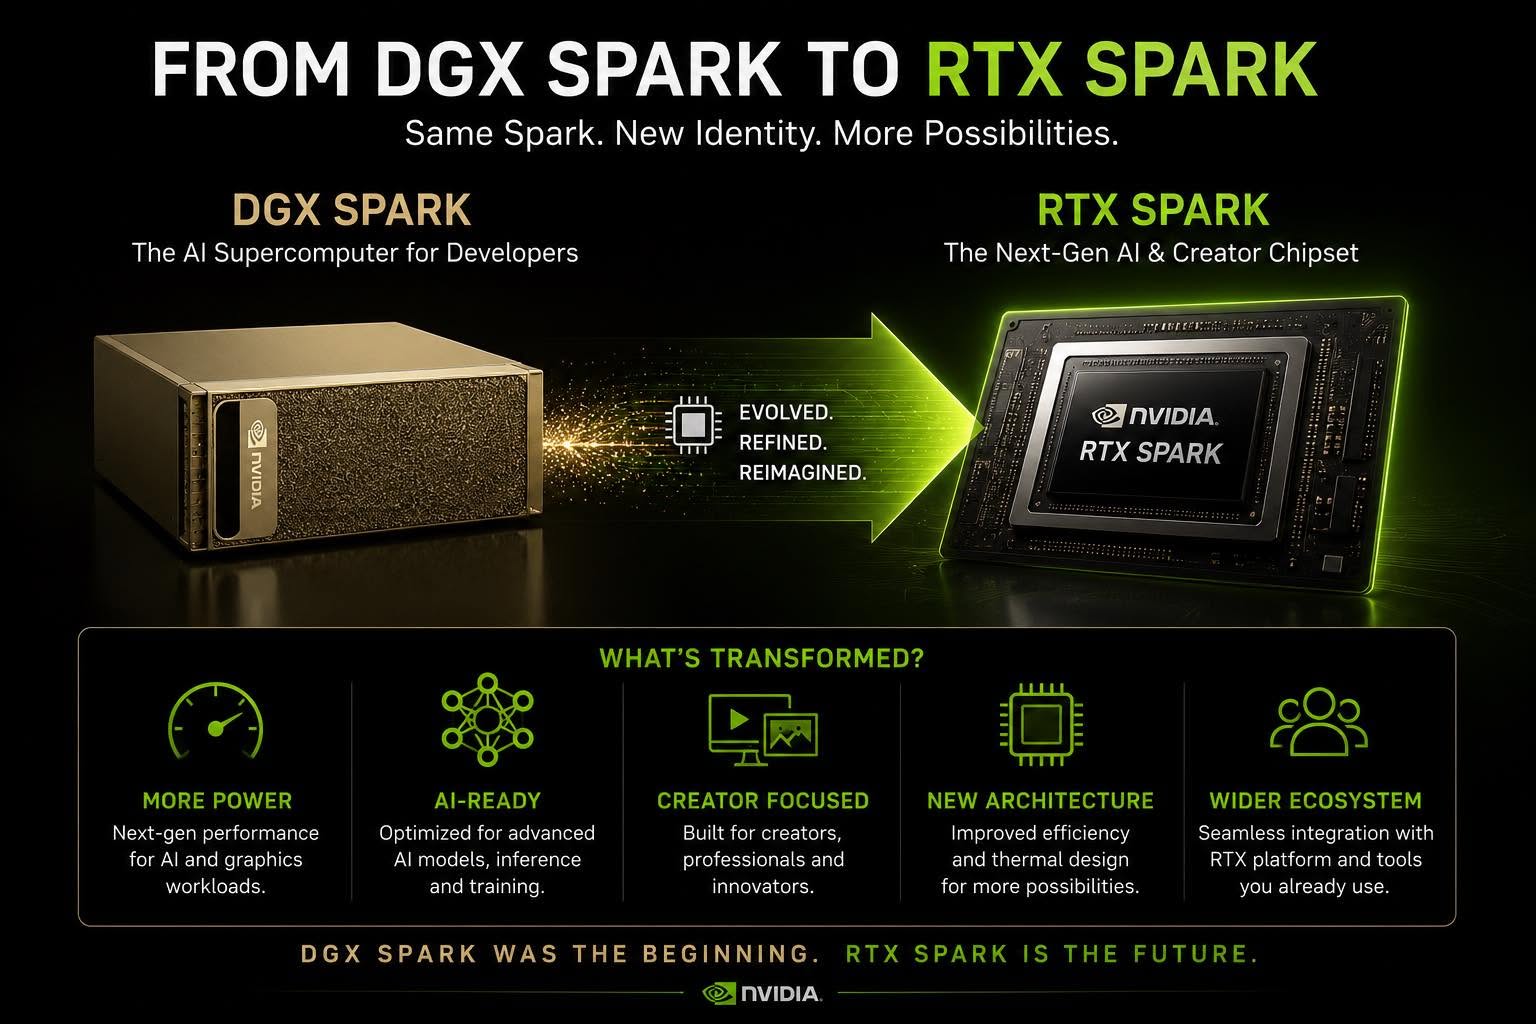
DGX Spark與RTX Spark兩方案都採用GB10(結合 Grace CPU + Blackwell GPU,擁有 128GB 統一記憶體與高達 1 PFLOP FP4 算力)這顆核心晶片,最大的差異則是配載的作業系統,前者採用DGX OS(以 Ubuntu 為基礎的 Linux),後者為Windows 11(Windows on Arm)。兩者的定位比較如下:
| 比較項目 | DGX Spark (開發者/企業沙盒) |
RTX Spark (個人消費/創作者 AI PC) |
|---|---|---|
| 核心定位 | 桌面級 AI 研發與超級算力沙盒 | 個人隨身 AI 代理、多媒體創作與全能 AI PC |
| 作業系統 | DGX OS(以 Ubuntu 為基礎的 Linux) | Windows 11(Windows on Arm) |
| 硬體產品形式 | 僅有固定式迷你桌機 | 輕薄筆電與迷你桌機 |
| 網路與擴充 | 搭載 ConnectX-7(200Gbps 高速互聯,支援串接與多機集群) | 標配 Wi-Fi 7 / 藍牙 5.4(注重無線與行動便利) |
| 繪圖/娛樂優化 | 專注 AI 矩陣運算,捨棄遊戲與娛樂優化 | 支援 DLSS 4.5、光線追蹤與硬體編解碼 |
| 目標使用場景 | 模型微調 (Fine-tuning)、本地推理、雲端/資料中心部署前的驗證 | 本地 AI 智能體運作、影音剪輯、3D 算圖、電競遊戲 |
從上表中進一步來看兩者的三大差異之處:
1. 作業系統與軟體生態 (OS & Software Stack)
DGX Spark預載 NVIDIA 原廠的 DGX OS (Linux),針對 AI 開發環境(如 PyTorch、CUDA 引擎、容器化工具)優化,成果可無縫轉移至企業級 DGX 雲端或資料中心集群。
相較之下,RTX Spark搭載 Windows 11 生態,直接對接一般消費者的軟體工作流,專為本地執行 Copilot / AI 代理、驅動創作者軟體(如 Adobe、DaVinci)而設計。
2. 擴充能力與串接能力 (Network & Scale-out)
DGX Spark具備 ConnectX-7 高速網路介面,允許透過專業網路硬體進行兩台或多台串接,共同載入高達千億級參數(4,000 億+)的大型模型,適合小型團隊或實驗室進行協同研發。
RTX Spark主要為單人獨立使用情境設計,無 ConnectX 串接功能,著重於攜帶性與個人端軟體體驗。
3. 娛樂與圖形處理 (Graphics & Entertainment)
DGX Spark為純算力導向,不針對遊戲或日常多媒體播放進行最佳化。RTX Spark則承襲 RTX 系列家族特性,支援 DLSS 4.5、光線追蹤加速與硬體編解碼技術,能在提供強大 AI 算力的同時,順暢執行 1440p/4K 3A 級遊戲與影片渲染。
再從價格與規格面來比較一下:
| 比較項目 | DGX Spark (企業/開發者工作站) |
RTX Spark (個人消費/創作者裝置) |
|---|---|---|
| 美金建議售價 (MSRP) | $4,999 – $6,950 美元 | $2,599 – $7,000 美元 |
| 台灣市場參考價 | 約 NT$ 175,900 – NT$ 245,900 | 約 NT$ 82,000 – NT$ 220,000 (依品牌與硬體配置而定) |
| 記憶體配置選項 | 64GB 或 128GB 統一記憶體 | 32GB、64GB 或 128GB 統一記憶體 |
| 硬體形式 | 固定式小型桌上型伺服器 / 工作站 | 輕薄筆電(如 Surface Laptop Ultra)與 Mini PC |
| 價格包含的溢價項目 | • ConnectX-7 200Gbps 高速網卡介面 • NVIDIA DGX OS 與企業級 AI 技術支援 • 內建企業級冷卻與多機串接能力 |
• 高解析度螢幕(筆電版) • 機身工藝、電池與無線模組(Wi-Fi 7) • Windows 11 授權與 DLSS 4.5 遊戲/多媒體最佳化 |
造成價格差異的核心因素包括:
1. 進入門檻差異(入門價格差距大)
RTX Spark 起售價約落在 $2,599 美元,針對消費市場提供較小記憶體(如 32GB/64GB)的基礎版本,大幅降低個人使用者進入 AI PC 與本地智能體的門檻。相較之下,DGX Spark 起價即為 $4,999 美元(64GB 版),頂配 128GB 版本價格達 $6,950 美元,沒有推出低階過渡產品。
2.企業網卡與硬體擴充成本
DGX Spark 內建了 ConnectX-7 200Gbps 高速網絡模組,允許進行多台機器直接連線串接以載入超大型模型,這部分硬體與通訊模組的成本大幅拉高了機器底價。
3.軟體授權與生態溢價
DGX Spark 的價格包含了 NVIDIA 企業級技術服務、專用的 DGX OS 支援以及 DLI 深度學習培訓資源,目標客群為企業研發團隊與實驗室。RTX Spark 則是將成本反映在消費者看得見的硬體規格(如 OLED 顯示器、鍵盤機身工藝與可攜性)。
AI 推論效能與性價比
在硬體核心同為 NVIDIA GB10 (Grace Blackwell) 系統單晶片,且皆配置 128GB 統一記憶體(Unified Memory) 的前提下,性價比(Price-to-Performance Ratio)上,128GB 的 DGX Spark 建議售價約 $6,950 美元,而同容量的 RTX Spark 估算落在 $5,000 ~ $6,000 美元(依品牌與筆電/桌機型態而異)。在 AI 推論效能(Inference Performance),兩者看似接近,但在單機極限與多機擴充(Scale-out)上呈現顯著差距:
1. 單機推論速度:RTX Spark 略勝(或持平)
-
記憶體頻寬:大語言模型(LLM)的 Decode 階段(生成 Token 的速度) 主要受限於記憶體頻寬(Memory Bandwidth)。DGX Spark 的 LPDDR5X 頻寬約 273 GB/s;而部分頂規 RTX Spark 品牌筆電採用較高頻的 LPDDR5X 記憶體,頻寬最高可達 ~300 GB/s。
-
實測推論速度:在執行 70B 參數模型(FP8 格式)時,兩者單機的推論生成速度約落在 3.0 ~ 3.5 tokens/sec 之間,RTX Spark 僅有極微幅的頻寬優勢。
-
作業系統負載:DGX OS (Linux) 運作背景雜訊極低;RTX Spark 的 Windows 11 (Arm) 雖有背景系統消耗,但若透過 DirectML / TensorRT-LLM 最佳化,推論吞吐量相差無幾。
2. 多機集群擴充(Scale-out):DGX Spark 完全碾壓
-
DGX Spark 的關鍵武器:硬體內建 ConnectX-7 200Gbps 高速網卡。
-
超大模型支援能力:透過 ConnectX-7,兩台 128GB 的 DGX Spark 可以直接高速串接,組成 256GB 的池化記憶體(Pooled Memory),進而流暢載入並執行 405B 參數 的超大型模型(如 Llama-3-405B)。
-
RTX Spark 的局限:沒有 ConnectX-7 網卡,只能單機運作,上限即為 128GB,無法載入超過單機記憶體容許範圍的大型模型。
如何挑選最適合您的本地端 AI 戰艦?
面對這兩款各自搭載 128GB 統一記憶體與 1 PETAFLOP 算力的強大硬體,開發者與企業團隊在進行採購決策時,最核心的分水嶺並非純粹的算力高低,而是軟體生態系的選擇以及最終產品部署的目標場景。
軟體生態與開發目標的分水嶺
從整體開發流程來看,兩款產品定位極為清晰。若您的核心目標是在原生的 Linux 環境下進行模型開發與微調,且未來的部署藍圖是將這些訓練成果無縫遷移至雲端資料中心或企業內部的伺服器機房,那麼 DGX Spark 無疑是首選。它能確保開發環境與生產環境達到完全一致,大幅減少跨平台轉譯的工程摩擦。
相對地,若您的需求是打造一台無懈可擊的個人主力工作站或高階筆記型電腦,希望能在本機端隨時呼叫 AI Agent協助日常工作,同時又必須兼顧 Windows 作業系統下的多工作業——無論是日常辦公、Adobe 與 DaVinci 的高畫質影音剪輯、AI 圖像生成、3D 算圖,乃至於下班後的遊戲娛樂——那麼 RTX Spark 則是最佳解方。
深度情境分析:極致性價比的考量與選型
若進一步從投資報酬率(CP 值)的角度來切入,不同使用者的最佳情境有著顯著差異。
對於獨立 AI 開發者、全棧工程師與全能型創作者而言,RTX Spark (128GB) 能展現出個人單機使用下最高的性價比與應用彈性。當您的核心任務是在本地端流暢執行 30B 至 70B 參數規模的大型語言模型、多模態模型或自律 Agent,同時又希望這台機器能一手包辦創作者與工程師的日常複合需求時,RTX Spark 提供了無可比擬的全能優勢,讓您在不需要放棄 Windows 豐富生態系的前提下,享有頂級的本地端 AI 算力支援。
另一方面,針對企業 AI 研發團隊、學術科研實驗室以及系統架構師,DGX Spark (128GB) 則展現了作為「企業級 AI 開發沙盒」的巨大營運效益。在企業級開發場景中,模型的整個運算管線最終都必須落腳於 Linux 伺服器;此外,若團隊規劃在未來採購兩台以上的設備,透過 ConnectX-7 進行高速集群串接,藉此推動 400B+ 參數規模的超大型模型,DGX Spark 正是不可或缺的基石。從打造穩定沙盒環境與降低異構系統間除錯開銷的長期視角來看,DGX Spark 能夠省去極大的工程隱形成本,其發揮的整體開發與維護性價比將遠勝於傳統工作站。
結論
總結來說,RTX Spark 是將 Windows 工作站全面升級為個人 AI 終端的極佳載體,兼顧了開發能力與全方位的生產力娛樂;而 DGX Spark 則是一台精緻縮小版的微型資料中心伺服器,讓企業與實驗室能在案頭以極低門檻預演並驗證大型 AI 專案。評估自身的工作流程是以 Windows 複合應用還是 Linux 生態部署為核心,便是解開這項選型難題的關鍵所在。

- NVIDIA RTX Spark vs. DGX Spark:地端AI開發者如何選擇? - 2026/10/14
- 常駐型AI代理時代:Meta Muse與OpenAI dots對決下的新變革 - 2026/10/05
- 從NVIDIA Cosmos認識世界基礎模型WFM - 2026/10/01
訂閱MakerPRO知識充電報
與40000位開發者一同掌握科技創新的技術資訊!