人工智慧產業在 2026 年迎來了新的轉折點。過往衡量大型語言模型(LLM)優劣的標準,往往停留在「文本摘要寫得好不好」、「數學算得準不準」或是「聊天是否自然」等單一指標;然而,隨著 OpenAI 推出 GPT-6 Astra、Anthropic 發布 Claude Fable 5.1(以及限制存取的 Mythos 5.1),加上 Google DeepMind 閃擊推出的 Gemini 3.8 Flash(含 Cyber 衍生版),全球 AI 戰局已正式從「對話問答」全面跨入「自主代理(Agentic Era)」與「電腦操作(Computer Use)」的實務戰場。
這場在短時間內陸續爆發的旗艦模型發布潮,帶來了前所未有的基準測試數據碰撞。令人注目的是,各家官方發布會上呈現的「第一名」各自表述,使技術社群產生了極大的混淆:GPT-6 Astra 宣稱在電腦視覺自動化與邊界安全領域全面封頂;Anthropic 的 Fable 5.1 則在獨立機構 Artificial Analysis 的 Coding Agent Index 與 Humanity’s Last Exam 測試中稱霸;而 Google 的 Gemini 3.8 Flash 則以不到對手十分之一的驚人價格,在程式開發基準測試上緊追頂級模型。
本文旨在摒棄單一廠商的行銷話術,以第三方權威基準測試(如 Artificial Analysis、DeepSWE v1.1、OSWorld 2.0、FrontierMath 等)的交叉驗證數據為基礎,針對這三款新世代模型進行深入的架構與技術剖析。我們將從實務導向的四大核心領域、API 經濟學、以及洩露的下一代架構進行解構,協助技術決策者與開發者釐清:在不同應用場景下,究竟哪一款模型才是真正的勝出者。
跨越螢幕邊界:GUI 自動化與電腦應用(Computer Use)
當前的 AI 自動化已不再滿足於呼叫 REST API 或執行簡單的 Python 腳本,而是要求模型能夠像人類一樣「看著螢幕、操作滑鼠與鍵盤」,直接在複雜的桌面 GUI 軟體中執行任務。在這項技術維度上,GPT-6 Astra 展現出了顯著斷層式的領先優勢。
Astra 搭載了 OpenAI 升級後的 Codex Harness 與高頻視覺-動作反饋迴圈(Vision-Action Loop)。在評估作業系統視覺自動化能力的 OSWorld 2.0 基準測試中,Astra 達成了 72.6% 的驚人成功率,且將單項任務的平均完成時間壓縮至 40 分鐘,速度較前代提升近兩倍。
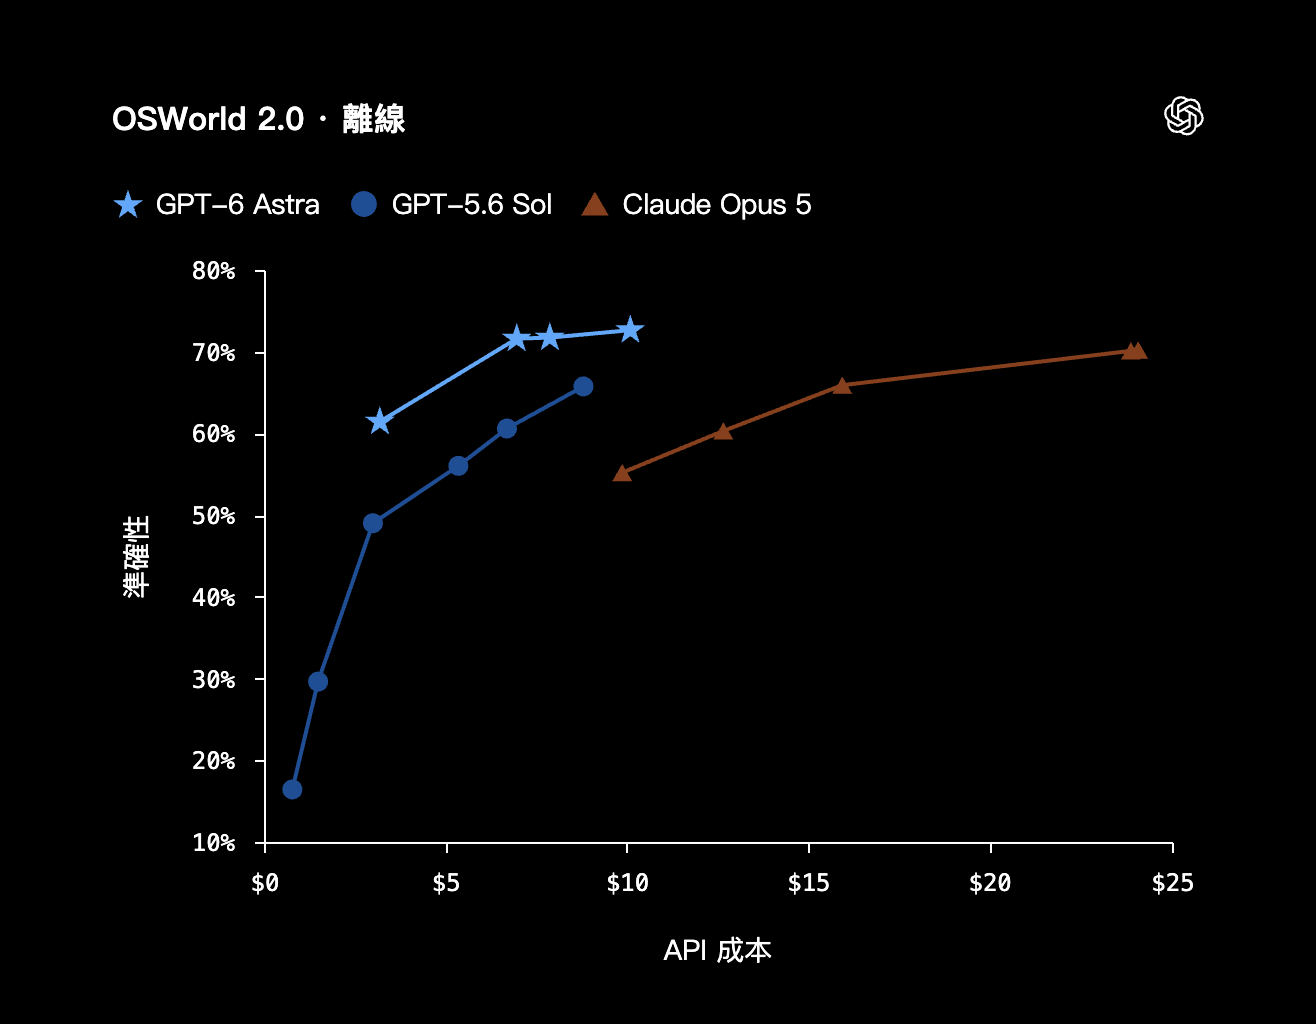
OSWorld 2.0 測試模型是否能透過操作電腦應用程式完成任務。Astra 的任務分數高於任何其他可用模型,而所用的輸出 Token 也大幅少於 GPT‑5.6Sol。(source)
最具代表性的範例在於其跨專業領域的實機操作能力:在 Unreal Engine 的實機展示中,Astra 能夠自主導航於 3D 介面之間,完成動態材質參數調整與資產佈局;而在硬體工程領域的 BenchCAD 測試中(Astra 取得 95.9% 的高分),它能解析多視角渲染圖,直接自動生成對應的 CAD 程式碼並進行 PCB 印刷電路板的佈線重構。
相對而言,Claude Fable 5.1 在 BenchCAD 評測中取得 84.3% 的佳績,其電腦操作能力側重於邏輯鏈條的穩定性與 API 階層的工具呼叫(Tool Use),而非高頻率的原生 GUI 動態互動。而 Gemini 3.8 Flash 雖然也支援基本的電腦操作,但 Google 的設計哲學將其定位於 DOM 網頁自動化與高吞吐量的多輪介面操作,對於極度依賴 3D 空間渲染或高精度 GUI 控制的軟體場景,Astra 無疑是目前最優異的選擇。
自主編程與工程維護:Coding Agent 的長程之爭
在軟體工程領域,評估標準已從「寫出短小演算法」轉變為「維護龐大程式庫與修復複雜 Bug」。這三款模型在此領域各據一方,形成了極具趣味的三角抗衡。
在第三方機構 Artificial Analysis 的 Coding Agent Index 獨立評測中,Anthropic 家族展現了強大的整體戰力。需要特別說明的是,在 Anthropic 的模型分級體系中,Opus 系列(如 Claude Opus 5.5)定位為極致推理與最頂尖能力,因此在榜單中佔據絕對高分;而 Fable 5.1 / Sonnet 系列則定位為「能力與速度平衡的中量級工作馬(Workhorse)」。在中量級 Agent 評比中,Fable 5.1 憑藉高達 62~66 分的 Coding Agent 指數成績與極高的回應效率,榮登該級距的編程龍頭。
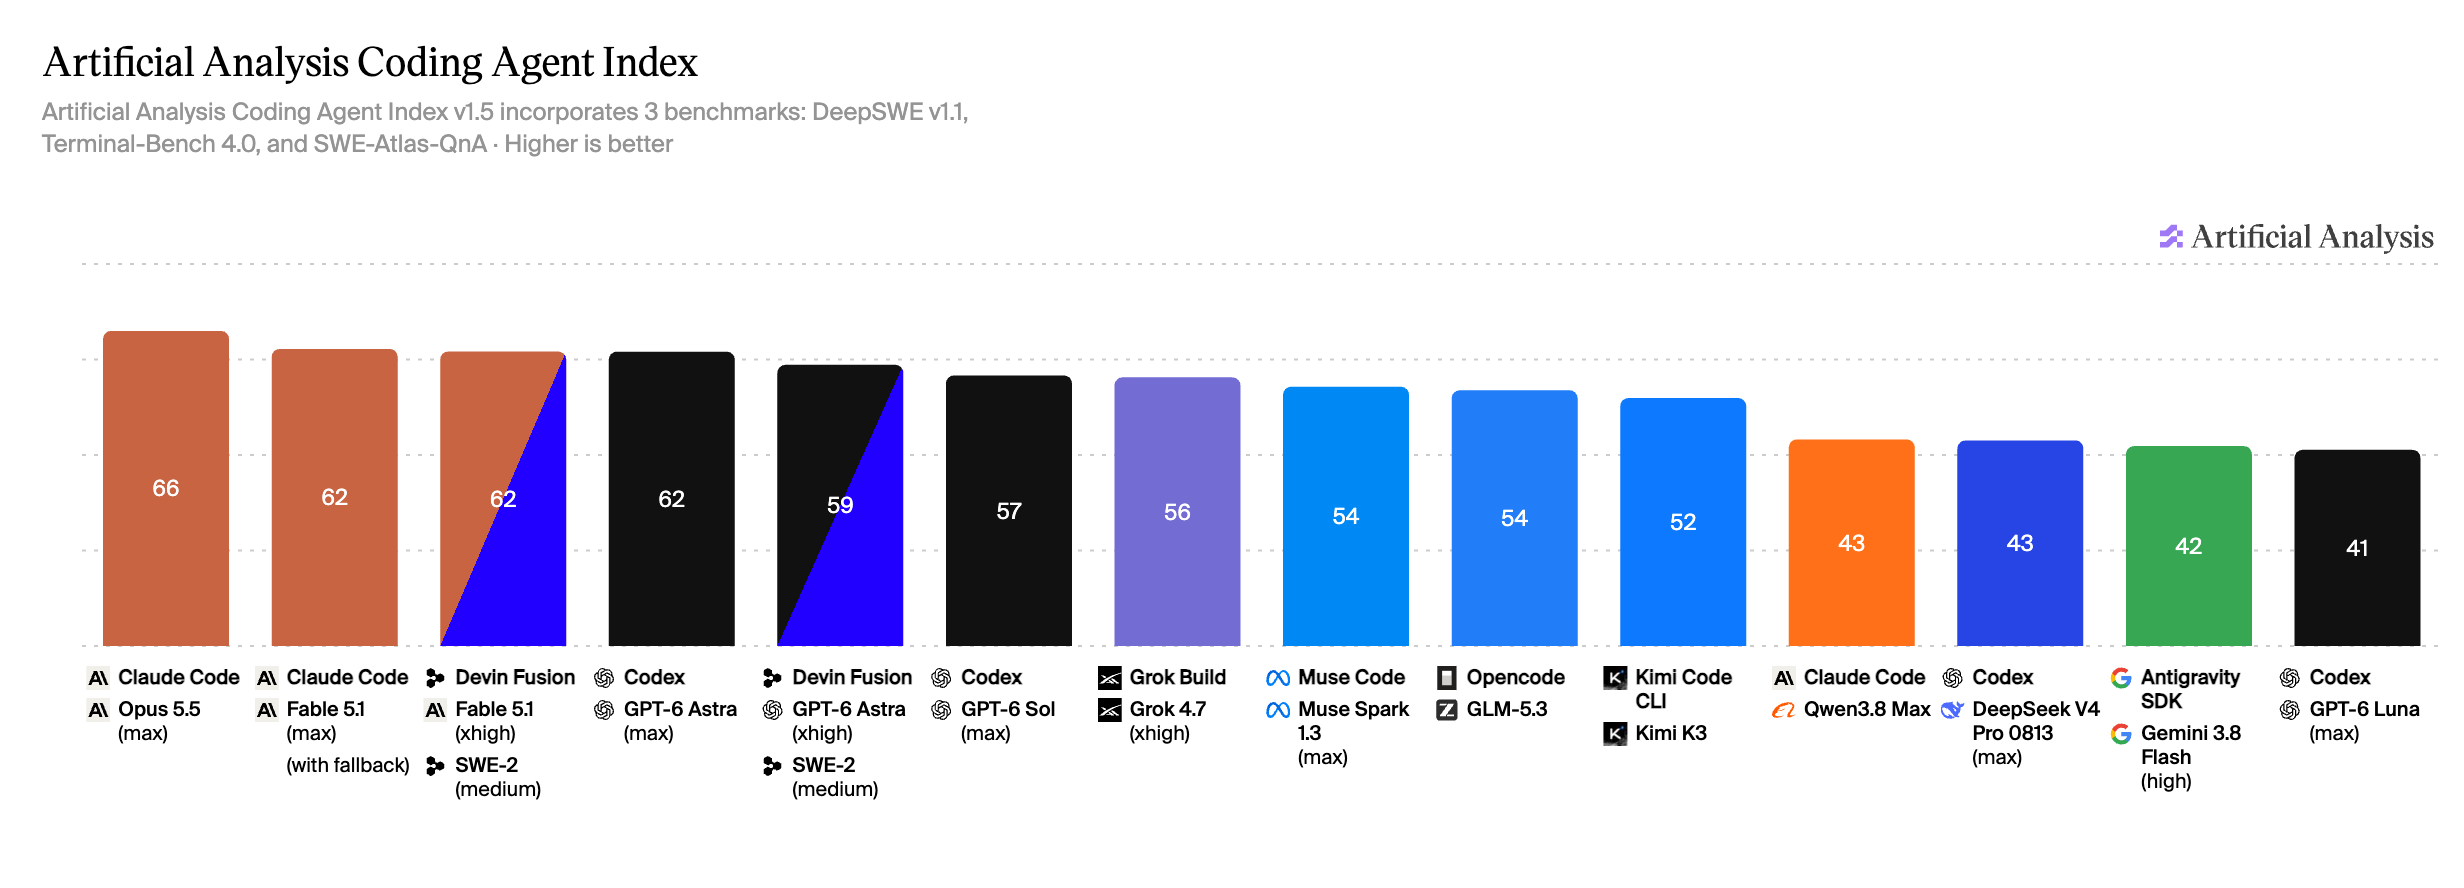
Artificial Analysis Coding Agent Index v1.5包含 3 個基準測試:DeepSWE v1.1、Terminal-Bench 4.0 和 SWE-Atlas-QnA。數值越高越好。(source)
Fable 5.1 的強項在於「長程(Long-Horizon)軟體工程專案」。透過其核心演算法 自適應思考(Adaptive Thinking),Fable 5.1 能在數小時的長程任務中持續自我校驗。更為關鍵的是 Anthropic 的 Prompt Caching(快取機制),當 Agent 必須在數千個檔案組成的大型 Repository 中反覆進行上下文讀取與程式碼追蹤時,Fable 5.1 能以極低成本持續重讀全庫,大幅減少上下文丟失引起的幻覺。
然而,在針對 GitHub 真實 Issue 進行自動修復的 DeepSWE v1.1 測試中,GPT-6 Astra 以 74.1% 的基準成功率微幅領先 Gemini 3.8 Flash 的 73.8%。這裡令人驚嘆的是 Gemini 3.8 Flash 的表現——作為一款定位為「高效能工作馬(Workhorse)」的中量級模型,Gemini 3.8 Flash 在 DeepSWE v1.1 的表現幾乎與 Astra 旗鼓相當。考慮到 Gemini 3.8 Flash 的 API 呼叫成本僅為 Astra 的十三分之一,對於需要建立大規模持續整合與自動修復(CI/CD Agent)的企業而言,Gemini 展現出了無可比擬的部署效益。
科學探索與網路安全:從前瞻研究到資安攻防
當 AI 進入前沿科學與關鍵基礎設施的防護領域,模型的推理深度與安全性邊界成為決勝關鍵。
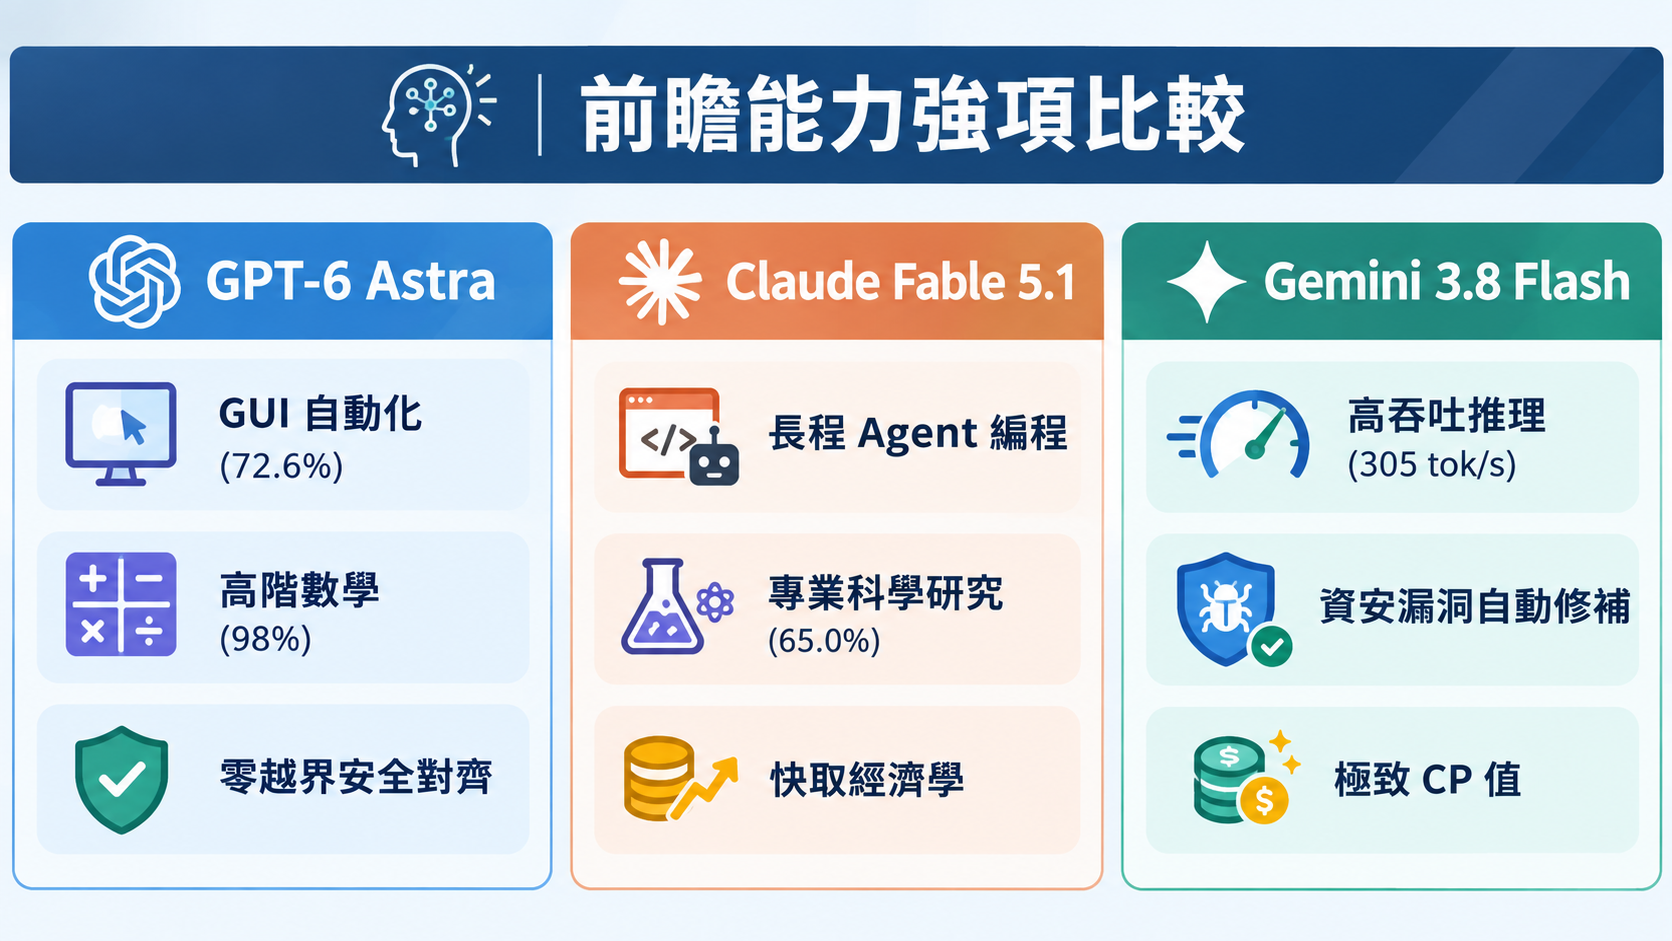
在科學研究層面,Anthropic 透過其 Mythos 5.1 計畫(Fable 5.1 的高階前瞻探索版本)展現了長程科學代理的突破。在結合外部專業工具的跨領域科學測試 Humanity’s Last Exam 中,Fable 5.1 取得了 65.0% 的高分,超越 Astra 的 57.2%。在實際應用中,Fable 5.1 成功整合生物資訊工具,完成自主優化蛋白質折疊與配體結合親和力的複雜實驗設計,並處理龐大的雷達合成孔徑數據以進行金星表面地形的自動化地圖繪製。相對地,GPT-6 Astra 則在傳統的高階理論數學與抽象科學領域領先,於 FrontierMath Tier 4 寫下了 98% 的高分,擅長純理論的數學證明導引。
在網路安全攻防層面,Google 推出了專為受信任防禦者打造的 Gemini 3.8 Flash Cyber。該模型在軟體供應鏈漏洞掃描、自動化程式碼打補丁(Vulnerability Patching)以及即時威脅分析中展現出超高吞吐量,能以毫秒級速度反應並生成修補方案。而 GPT-6 Astra 在攻防測試 ExploitBench 中拿下了 100% 的極限成績。
值得關注的是 OpenAI 在 Astra 上實現的安全對齊(Alignment)進展:相較於前代模型在無生產安全防護時高達 48% 的授權目標越界率,Astra 在嚴格的測試條件下成功將越界操作率降至 0%,解決了長期以來自主代理可能因失控而破壞系統環境的致命隱患。
橫向數據與 API 經濟學剖析
要評估一款模型是否能真正進入企業生產流程,性能評測僅是一半的解答,另一半則取決於 Token 經濟學(Pricing Economics)與生成速度(Throughput)。
下表彙整了三大模型在獨立評測機構與官方規格中的關鍵性能與成本數據:
表一:三款旗艦 AI 模型核心技術與經濟指標比較表
| 評比指標 / 模型 | OpenAI GPT-6 Astra |
Anthropic Claude Fable 5.1 |
Google Gemini 3.8 Flash |
|---|---|---|---|
| 上下文視窗 (Context Window) | ~1.05M Tokens | 1.0M Tokens | 1.0M Tokens |
| 最大單次輸出 (Max Output) | 128K Tokens | 128K Tokens | 未公開 (高深度推理支援) |
| 輸入價格 (每 1M Tokens) | $10.00 USD | $10.00 USD | $0.75 USD (推廣期定價) |
| 輸出價格 (每 1M Tokens) | $50.00 USD | $50.00 USD | $3.75 USD (推廣期定價) |
| 快取讀取價格 (Cache Read) | $1.00 USD | $0.25 USD | $0.075 USD |
| 生成速度 (Output Throughput) | ~87 tok/s | ~67–69 tok/s | ~305 tok/s |
| OSWorld 2.0 (GUI 自動化) | 72.6% | 未完全公開 (BenchCAD 84.3%) |
基礎網頁 DOM 級支援 |
| DeepSWE v1.1 (軟體工程) | 74.1% | ~70 (Coding Agent Index) |
73.8% |
| Humanity’s Last Exam (科學) | 57.2% | 65.0% (via Mythos 5.1) |
未公開 |
(註:Gemini 3.8 Flash 的 $0.75/$3.75 定價為推廣期優惠,優惠結束後標準價為 $1.50/$7.50,仍僅為對手的約十分之一;Fable 5.1 的快取讀取費用為輸入價的 1/40。)
從數據中可以清楚看出 API 經濟學的差異:
1. Fable 5.1 的快取護城河:儘管 Fable 5.1 的名義標價($10/$50)與 Astra 相同,但其快取讀取費用僅需 $0.25/1M Tokens。對於需要在長達數小時的迴圈中反覆載入相同代碼庫或法律卷宗的 Agent 工作流,Fable 的實際營運成本能下降 70% 以上。
2. Gemini 3.8 Flash 的破局戰略:Gemini 3.8 Flash 以高達 305 tokens/s 的生成速度,搭配極低的 API 門檻,直接顛覆了高效能模型的部署成本模型。對於日常高頻次的文字分類、API 路由、日誌解析以及龐大代碼庫的即時掃描,Gemini 提供了其他兩家無法比擬的商業效益。
結論
綜合以上分析,2026 年的 AI 戰場已無法用簡單的「單一勝負」來定調。GPT-6 Astra、Claude Fable 5.1 與 Gemini 3.8 Flash 分別代表了 AI 發展的三個極致方向:跨軟體端到端操作能力、長程邏輯與專家級科學 Agent,以及高吞吐量與極致成本效率。
表二:三款 AI 模型之企業部署選型決策表
| 企業應用場景 | 首選模型 | 關鍵選型理由 |
|---|---|---|
| GUI 電腦自動化與 視覺 CAD 操作 |
GPT-6 Astra | 在 OSWorld 2.0 (72.6%) 與 BenchCAD (95.9%) 居領先地位, 支援 Unreal Engine 及 PCB 設計等實機操作,對齊安全性極高。 |
| 長程式庫維護與 長程研究 Agent |
Claude Fable 5.1 | Coding Agent Index 奪冠,搭配 $0.25/1M 的 Prompt Caching 機制, 極適合長耗時、高重複 context 的軟體專案與科學研究。 |
| 大規模企業自動化、 資安修補與高頻 API |
Gemini 3.8 Flash / Cyber |
擁有 305 tok/s 的極速回應與 DeepSWE (73.8%) 性能, 成本僅對手 1/13,專用 Cyber 版可精準修補供應鏈漏洞。 |
決策者在進行架構選型時,應擺脫「追逐最高名次」的盲點,轉而評估任務的風險邊界、工作時間軸長短以及API 預算結構。唯有將合適的模型放置於相應的工作流程中,才能在數位轉型的浪潮中發揮最大的營運價值。
(責任編輯:歐敏銓)
》延伸閱讀與技術出處
-
Artificial Analysis 獨立評測:GPT-6 Astra 與 Gemini 3.8 Flash 橫向對比
-
DEV Community 技術深度解析:Astra vs Fable 5.1 vs Gemini 3.8 Flash 三強基準對比
-
Agent Guide 模型策略比較:GPT-6 Astra、Gemini 3.8 Flash 與 Claude Fable 5.1 部署指南
-
Google DeepMind 發布公告:Gemini 3.8 Flash 及 Gemini 3.8 Flash Cyber 架構解析
- 自主代理時代:GPT-6 Astra、Claude Fable 5.1與Gemini 3.8 Flash技術比較 - 2026/09/24
- 微軟報告:全球AI普及率升至18.8%、南北半球鴻溝持續擴大 - 2026/09/24
- 聯發科開啟以AI為核心的筆電新世代 - 2026/09/23
訂閱MakerPRO知識充電報
與40000位開發者一同掌握科技創新的技術資訊!