一本本書被拆去書背、逐頁掃描,化為數位檔案,最後被送進回收廠。乍看之下是一場數位化行動,但當這些被「數位化」的書,不只一兩本,而是成千上萬本時,這就不再只是保存或轉換格式那麼簡單。
當人類積累多年的知識,被少數公司收集、轉化成模型訓練的工具,再透過AI重新提供給大眾,我們或許正在逐步失去對知識的解釋權。不只是知識如何被保存,更包括什麼被看見、如何被理解,以及誰有權決定它應該如何被理解。
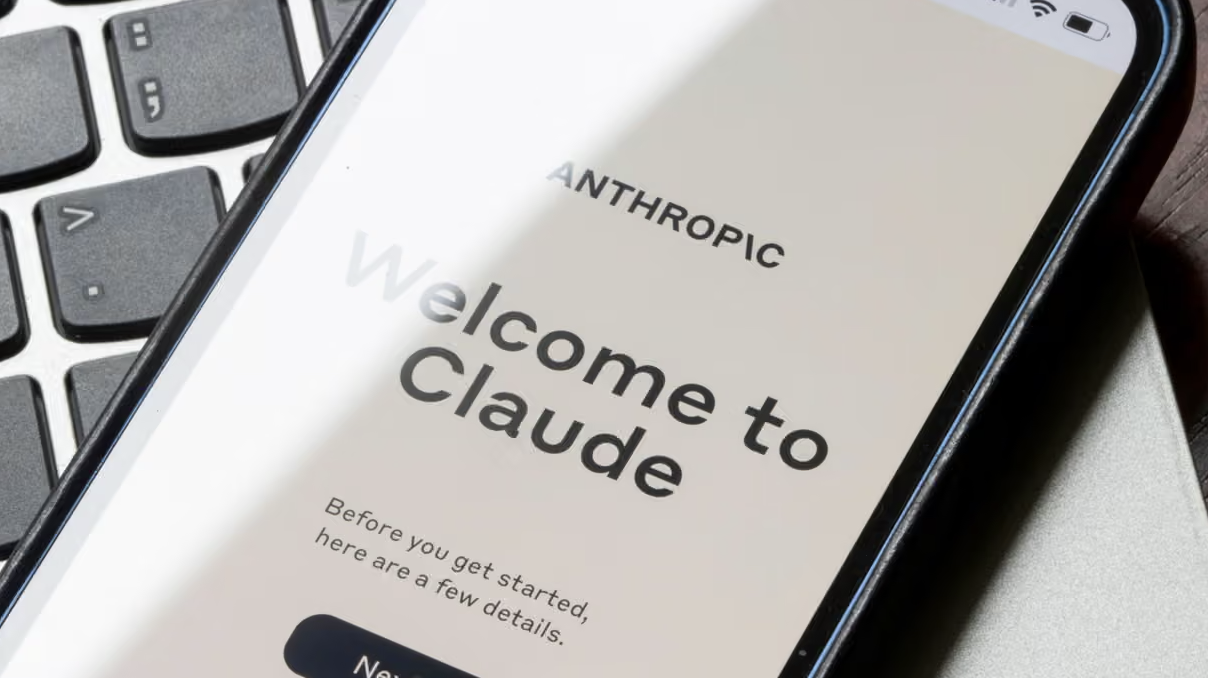
近期曝光的Anthropic「Project Panama」,正好讓這個問題浮上檯面。
買書、掃描、銷毀
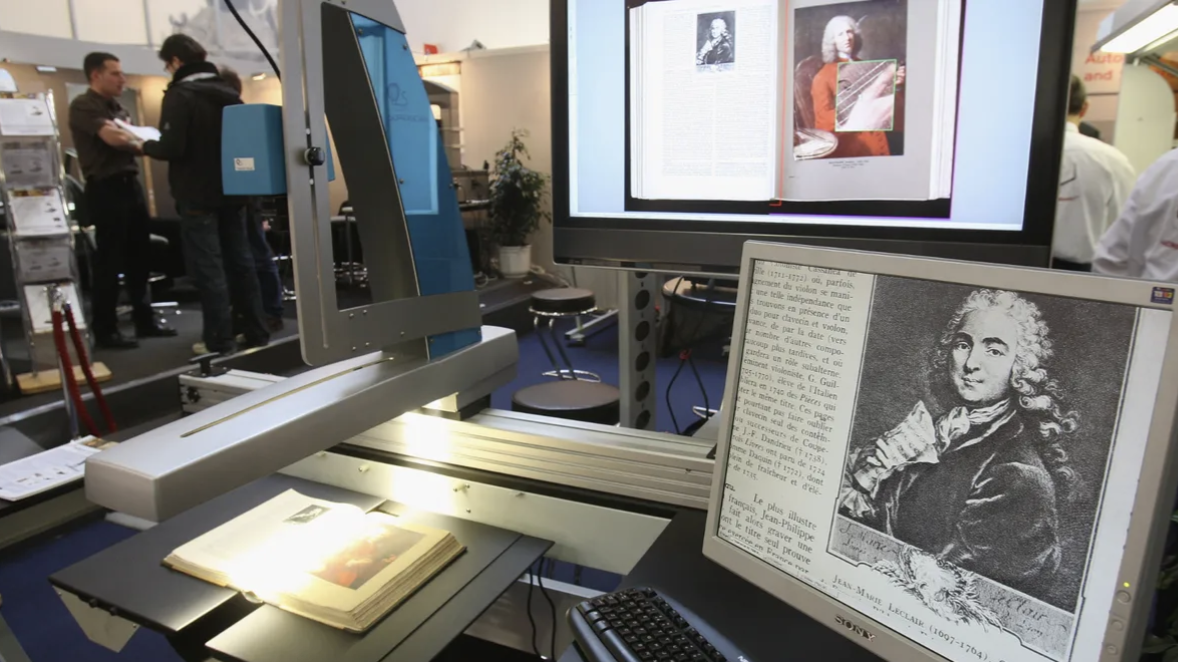
美國《華盛頓郵報》揭露Anthropic一項名為「Project Panama」的計畫。根據內部文件,Anthropic將書籍視為高品質的AI訓練資料來源,計畫大量購買實體書,再透過拆除書背、快速掃描的方式將內容數位化,最後丟棄原本的實體書。將書籍拆解後逐頁數位化,這種破壞性掃描本身並非AI時代才出現,圖書館進行大量典藏數位化時也可能採用類似方法。但是真正引起爭議的,是AI公司以極大規模取得書籍,並將其轉化為模型訓練資料。
(圖片來源)
但當這些知識被集中進入私人模型,這些被數位化的知識,還是原本的知識嗎?書籍有一個非常重要的特性:它是一個可以被人類共同取得、保存、引用與反覆解讀的載體。一本學術著作放在圖書館裡,研究者可以翻到原文,看作者究竟寫了什麼;不同學者可以提出不同解釋;後來的人也可以引用、批判甚至推翻前人的觀點。
在這裡,知識跟解釋是分開的,一千人眼中可以有一千個哈姆雷特。但當它們進入AI後,兩者之間的關係正逐漸模糊。在過去,獲取知識的流程是「第一手資料—書籍—讀者」,透過AI後,可能轉變為「第一手資料—書籍—AI—讀者」,看似AI為我們提升了效率,實際上它也在剝奪我們為知識劃下註解的可能。因為我們不必完整閱讀資料,只需要接受AI為我們統整好的答案。當人類越來越依賴AI替自己閱讀、整理、比較與解釋,AI公司控制的就不只是資料,而是「如何解釋這個社會」的權力。
知識的解釋權
只要AI有足夠大的資料集、運算能力以及模型,就能夠把數以百萬計的書籍、論文、新聞、網頁與其他創作,濃縮成一個「答案」。使用者不會知道這個答案後面引用了多少資料,資料後面又衍生了多少種解釋,也不會知道AI最後採用了哪一種版本,以及它為什麼選擇這個版本。
圖書與學術資料一旦被數位化並納入封閉的商業模型,原本存在於公共世界中的文化與知識,便可能以另一種形式存在於企業控制的系統之中。這並不代表AI「偷走」了所有知識,也不代表模型本身就是一種知識壟斷。真正值得警惕的地方在於:原本任何人都可以閱讀與重新解釋的第一手材料,未來可能越來越少人會直接接觸,越來越多人只接觸AI替他們整理過的版本。
(圖片來源)
AI不會告訴我們哪裡有資料,而是選擇直接把答案餵給我們。這帶來巨大的便利,同樣也帶來新的問題。固然能夠從AI處直接獲取答案,但我們也許永遠不知道在這個答案的背後,其實還存在其他版本的解釋。它確實可以讓我們接觸過去難以搜尋、理解的知識,但我們也必須保留「回到原文」的能力。否則,人類失去的可能不是書,而是比較不同觀點、重新解釋的能力。真正值得警惕的「焚書」,不只是書被毀掉,而是我們不再需要打開書,因為AI已經替我們讀完了,而我們也忘了追問:「為什麼是這樣解釋?」
小結
《一九八四》的男主角溫斯頓,效命於真理部,唯一的工作就是宣傳和修改歷史。他們掌握了知識的修改及解釋權,也掌握了人們思考與理解世界的方式。早在20世紀,喬治·歐威爾就揭露了當知識被少數人掌控,人們面對的「真實」也隨之被重塑。AI或許還不會如小說中所描繪的那一步,但我們或許應該開始思考:當獲取知識的方式被少數公司壟斷,我們該如何判斷眼前的資料是否可信。
延伸閱讀
- 當AI開始「焚書」:誰掌握最後的解釋權? - 2026/09/18
- 從「半人馬」到救援現場:機器進入災害救援 - 2026/09/11
- 從《魔戒:獵捕咕嚕》看AI進入電影產業的新階段 - 2026/09/03
訂閱MakerPRO知識充電報
與40000位開發者一同掌握科技創新的技術資訊!