當AI運算從模型訓練延伸至個人電腦、企業推論與代理式工作流程,處理器設計也必須重新分配運算、記憶體及資料傳輸資源;英特爾在日前舉辦的一場媒體交流會中,針對新一代處理器架構進行了詳細的說明,揭露Core 系列 3、GPU D系列與下一代 Xeon 的技術細節,展現其依據不同工作負載,調整晶片分割、封裝與互連架構的思路。
以雙晶片封裝降低先進製程的導入成本
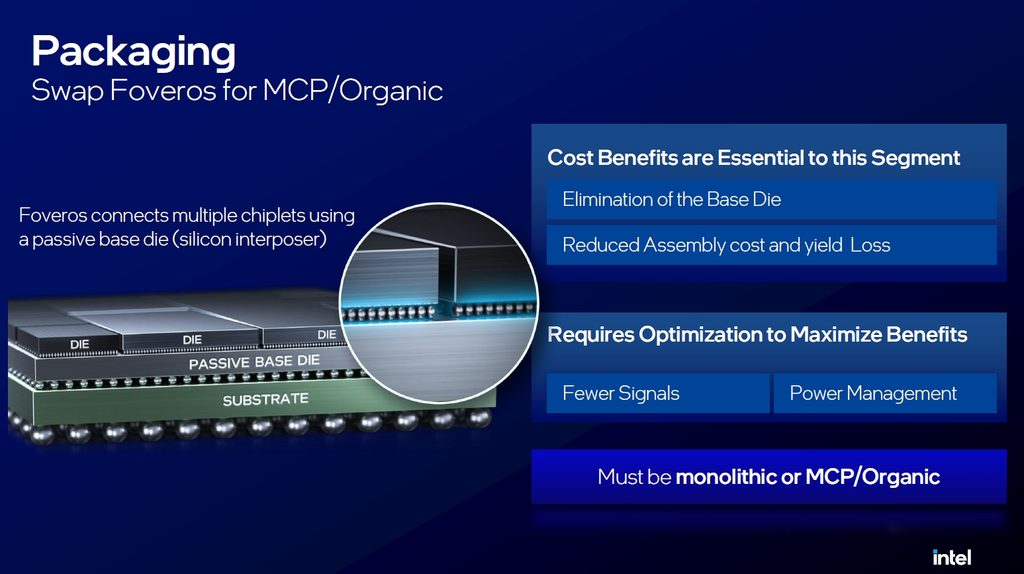
代號Wildcat Lake的Core系列3處理器透過封裝整合不同製程,以兼顧新一代運算能力與主流市場的成本需求。英特爾電腦通訊事業群產品經理余孝倫指出,將I/O電路微縮至Intel 18A製程,在設計難度與成本上未必具有優勢,因此負責CPU、GPU等運算的晶粒採用18A製程,平台控制晶粒則採用台積電(TSMC) N6製程,再以有機基板上的多晶片封裝(MCP)整合,並透過UCIe互連。相較於Core Ultra系列3處理器採用的Foveros方案,這項設計也省去被動基底晶粒,進一步降低封裝成本。
(圖片來源:Intel)
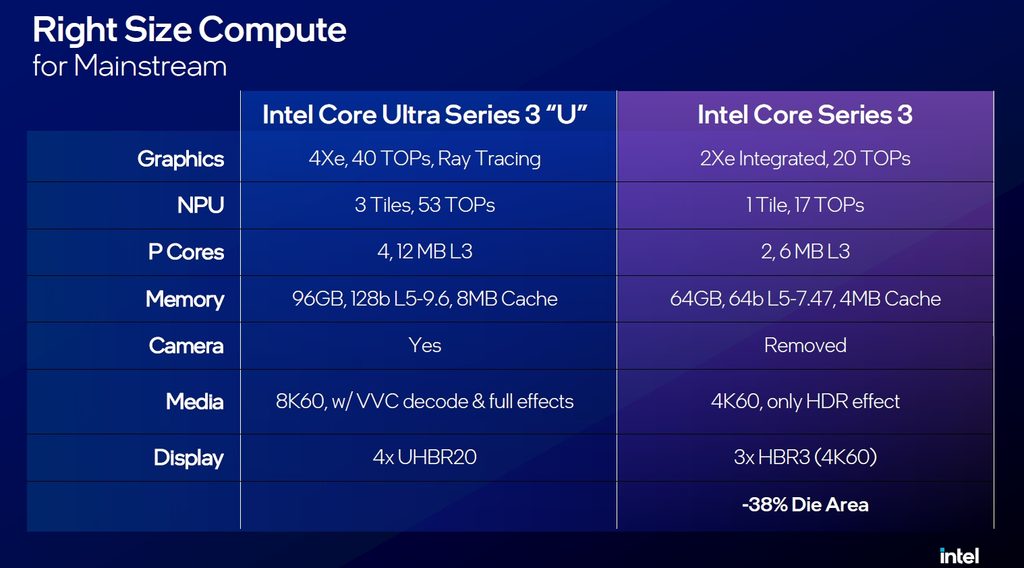
在規格配置上,英特爾採取「減法設計」思維,保留新一代運算IP,並沿用既有的研發與驗證成果,再依主流應用需求調整運算規模與周邊功能。Wildcat Lake最高配置兩個Cougar Cove效能核心、四個Darkmont低功耗效率核心及兩個Xe3顯示核心;第五代NPU的內部運算tile則由Core Ultra系列3 處理器配置的三個減為一個,最高提供17TOPS,CPU、GPU與NPU合計的平台AI 算力最高為 40 TOPS。
周邊功能的調整包括將媒體處理規格由 8K60 降至 4K60、移除原生 MIPI 相機介面,以及將 PCIe 配置精簡為6條 PCIe 4.0,同時保留兩個 Thunderbolt 4 連接埠及既有 USB 配置。透過運算與 I/O 資源的整體調整,相較於 Core Ultra 系列 3 的對應配置,運算晶粒與 I/O 晶粒面積分別縮小約 38% 及 15%。
記憶體採用 64 位元單通道設計,支援 LPDDR5X-7467 或 DDR5-6400,搭配 4MB 記憶體側快取,減少外部DRAM存取;日常輕負載則可交由低功耗效率核心處理,降低喚醒效能核心的需求。單通道設計也簡化主機板佈線,使板層可由8層降至6層,加上封裝尺寸縮至 35×25×1.23mm,進一步減少板面積與系統成本。
(圖片來源:Intel)
成本控制也延伸至晶粒分級。部分效能核心、顯示核心或NPU未達要求的晶粒,仍可透過關閉相關單元,配置到其他產品。例如最低階PC型號採一個效能核心與一個Xe核心,部分嵌入式配置則可不含NPU。不過,四個低功耗效率核心、顯示流水線及I/O必須保持完整,讓英特爾在提高晶粒利用率的同時,維持續航與平台功能的一致性。
UCIe導入主流 PC 關鍵在時序與低功耗管理
有機基板降低封裝成本,卻增加晶粒互連的難度。這兩種設計的凸塊間距由 36 微米放大至 110 微米,相同面積可容納的訊號連接數因此減少。英特爾必須擴大互連介面與控制器,相關區域面積增加約 70%,再以較精簡的平台頻寬需求,換取整體封裝成本下降。
更棘手的是資料封包化之後的時序。原本直接連接的訊號改以封包傳送,會產生額外延遲,但部分旁帶控制訊號仍循原有路徑,兩者的到達順序可能改變,影響開機、除錯、安全及顯示流程。余孝倫表示,這是驗證投入最多的部分,團隊透過可設定的熔絲與備援選項,處理鏈路啟動及訊號時序問題。
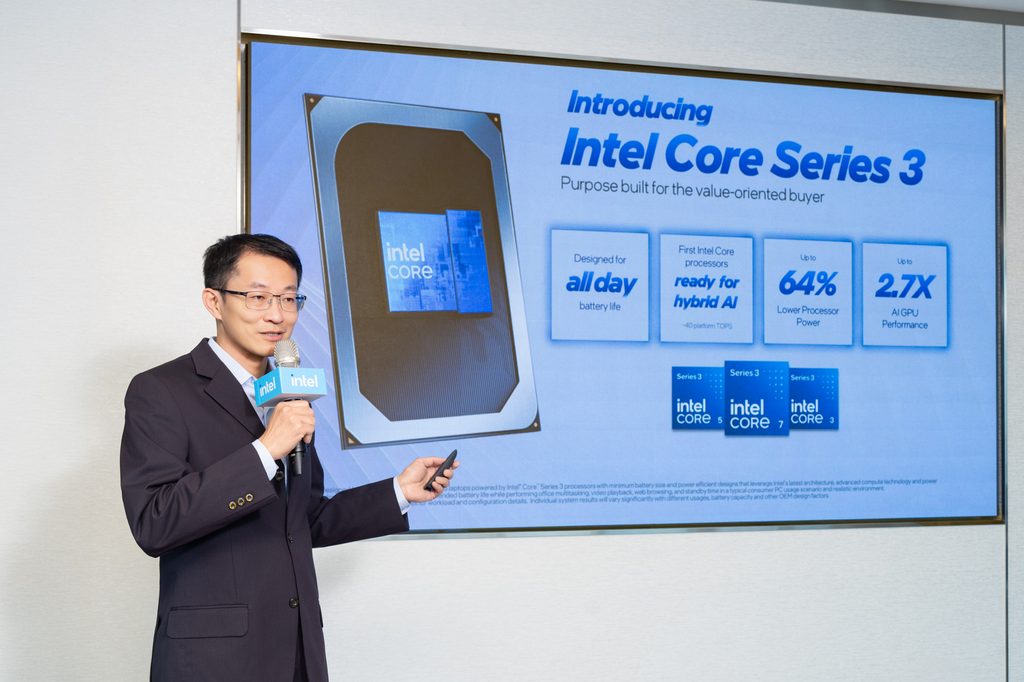
英特爾電腦通訊事業群產品經理余孝倫 (照片提供:Intel)
省電也不能只看CPU核心。若面板不支援自我更新(PSR),即使畫面靜止,顯示資料仍須持續通過UCIe。英特爾因此導入多種鏈路電源狀態與顯示流量 QoS 排程,讓資料集中傳送後,鏈路有機會進入較低功耗狀態。傳輸速率上限設定為 8GT/s,配合訊號完整性驗證,省去重傳與前向錯誤更正機制;供電也沿用既有VCCAON 電源軌,無須額外增加板上 LDO。
這些調整的成效反映在特定的工作負載上。英特爾以PL1同為15的Core 7 360與Core 7 150U 參考平台比較,前者在YouTube 4K串流時的處理器功耗最多降低 64%,Geekbench AI 1.6 GPU FP16 效能約為後者的 2.7 倍。兩者記憶體與軟體配置仍有差異,數據應視為平台實測結果,不能直接等同於整機耗電或所有應用的改善幅度。
GPU D 系列以記憶體容量支撐長上下文推論
從主流PC到資料中心,依應用需求配置運算資源,是英特爾貫穿不同產品線的設計思路。英特爾業務暨行銷事業群商用業務總監鄭智成指出,代理式AI的工作負載同時帶來記憶體容量、推論延遲與系統吞吐量的壓力,必須從整體運作需求考量硬體配置。代號 Crescent Island 的 Intel GPU D 系列,便是針對這些需求打造的推論加速器。
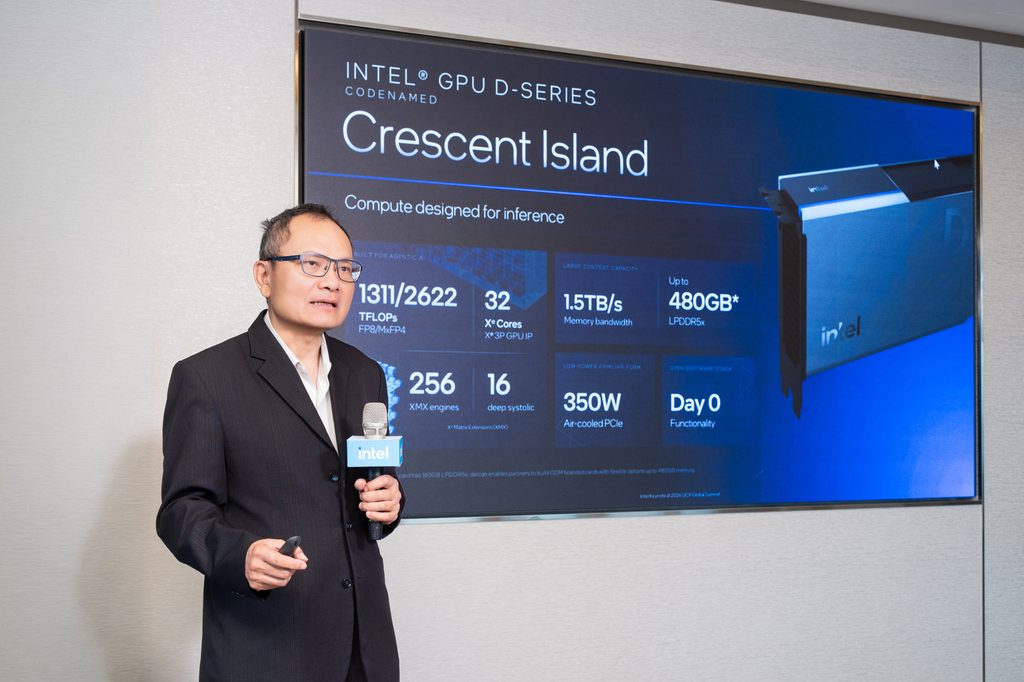
英特爾業務暨行銷事業群商用業務總監鄭智成(照片提供: Intel)
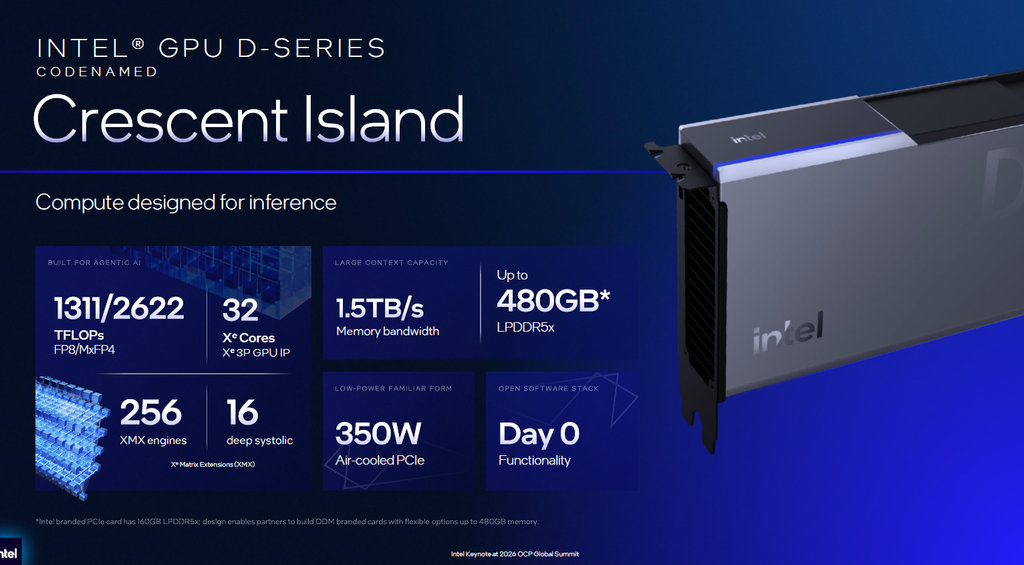
這款GPU採Xe3P架構,配置 32 個Xe核心與256個XMX矩陣引擎。相較Xe3,XMX的脈動陣列深度由四級增至十六級,新增FP8、FP4與Microscaling格式支援;每個Xe核心的通用暫存器容量增至1MB,並配置32MB統一L2 快取,以配合推論所需的矩陣運算與資料供應。
每個Xe核心另配置512KB的L1快取/共享區域記憶體,讓核心附近保有更多資料。從暫存器、片上快取到外部記憶體,這些調整共同支撐矩陣引擎運作,避免只增加運算單元,卻未同步擴大資料供應資源。架構同時保留完整速率的FP64運算,涵蓋從低精度 AI 到雙精度運算的不同需求。
其記憶體設計採LPDDR5X,頻寬達1.5TB/s,英特爾自有PCIe板卡配置160GB,合作夥伴可依需求設計最高480GB的版本。在350W氣冷規格下,公布的FP8運算能力約為 1.3PFLOPS,MXFP4約為2.6PFLOPS,並針對運算密集的預填充(prefill)階段最佳化。
(圖片來源: Intel)
鄭智成強調,模型權重能放進記憶體,只是推論部署的起點。長上下文與多人同時使用,還需要保留足夠空間存放注意力運算的KV快取。因此,較大容量的價值也在於支援更多並行工作階段,避免模型載入後,剩餘記憶體不足以處理實際任務。
相應的軟體設計包含感知KV快取位置的請求路由與快取卸載機制,將資料配置納入推論服務的調度。對長時間運作的代理程式而言,硬體容量、快取管理與請求排程必須共同考量,才能將記憶體規格轉化為可同時服務的工作量。
標準PCIe與氣冷設計則有助於沿用既有伺服器基礎設施。英特爾也延續Xe軟體架構,搭配 oneDNN、Triton、SYCL 等工具,降低不同GPU平台間的移植負擔;實際服務效率仍取決於模型精度、上下文長度、批次大小與軟體最佳化。
Diamond Rapids 以集中式互連擴展 CPU 資源
代理式AI對CPU的需求來自模型推論之外的執行流程。鄭智成指出,請求分類、資源協調、搜尋與工具呼叫,以及產出程式碼後的執行都需要CPU的支援。這也使得處理器核心數、記憶體頻寬與I/O能力等條件,成為AI系統能否持續供應加速器工作負載的關鍵。
下一代Intel Xeon處理器「Diamond Rapids」採用 Fan-out Fabric 架構,由中央Fabric Hub集中處理記憶體與I/O連接,再串接四個運算建構區塊,最高提供256個效能核心與合計1.28GB末級快取。其重點是運算區塊與資料交換樞紐的分工,Fan-out 在此描述的是互連拓樸。
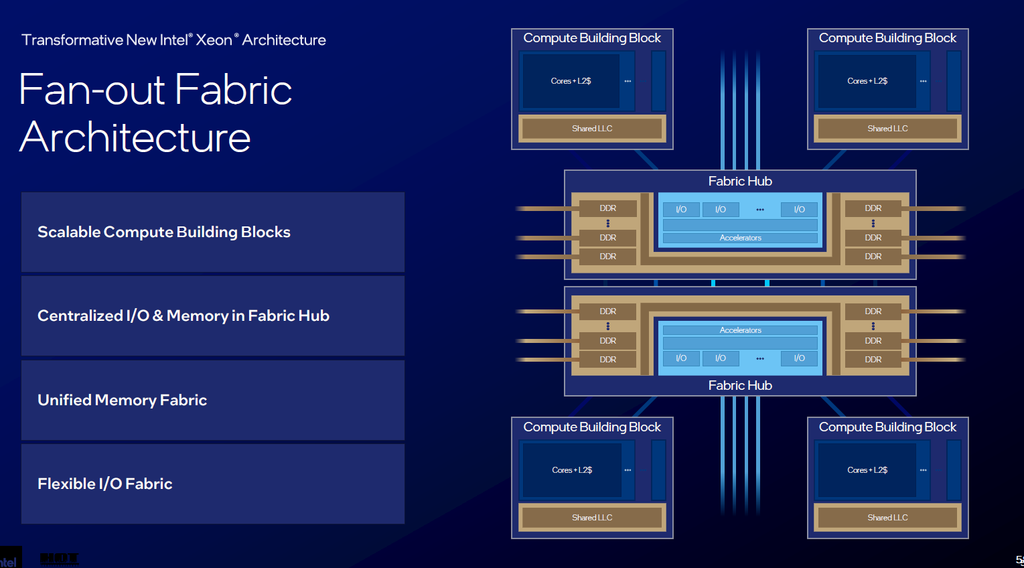
(圖片來源:Intel)
實體結構包含16顆Intel 18A-P核心小晶片、4顆 Intel 3-T 基底晶粒,以及兩顆 Intel 3 Fabric Hub。垂直方向採 Foveros Direct 3D 混合鍵合,基板上的晶粒間連接則使用 16GT/s UCIe-S,結合不同製程與互連方式,擴大運算規模。
製程方面,英特爾以標準核心子區塊評估,18A-P 相較18A可在相同效能下降低約18%功耗,或在相同功耗下提升約9%效能。其熱阻降低約20%~40%,導通孔電阻降低約10%~30%,並增加臨界電壓選項,讓設計者有更多功耗與速度的配置空間。不過鄭智成強調,這些屬於製程層級的改善指標,尚不能直接解讀為整顆Xeon的效能增幅。
記憶體子系統提供16個通道,支援最高8,000MT/s DDR5或12,800MT/s MRDIMM,搭配128條PCIe 6.0/CXL 3.0通道。AMX與AVX 10.2 則強化矩陣、向量及低精度AI運算,使 CPU 能承擔部分推論任務,並以更高的資料供應能力支援異質運算。
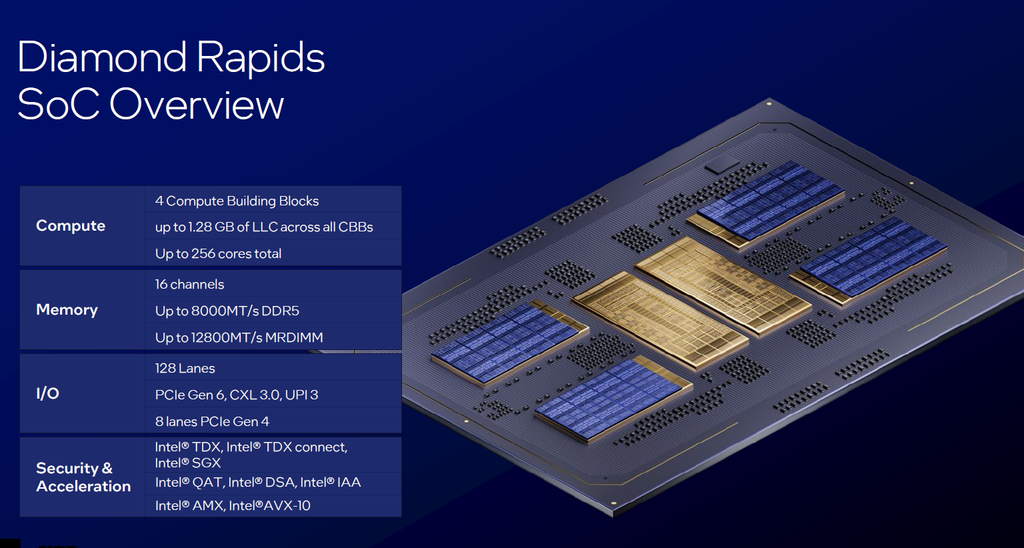
(圖片來源:Intel)
從Wildcat Lake精簡平台資源,到Crescent Island擴充推論記憶體,再到Diamond Rapids重整資料交換架構,英特爾呈現的共同方向是讓運算單元、封裝與記憶體配置配合實際工作負載。對系統開發者而言,評估新平台的重點,也將更集中於資料搬移成本、持續運作功耗,以及整個應用流程的吞吐量。
本文同步刊登於合作夥伴媒體矽島通訊社 | Silicon Press,歡迎關注!
- 從主流PC到代理式AI 英特爾以封裝與記憶體設計重塑處理器架構 - 2026/11/16
- 從連網走向自主智慧 Ceva以系統級IP布局實體AI - 2026/11/09
- EDGE AI Taipei 2026:串聯全球生態系、拓展邊緣AI商機 - 2026/10/28
訂閱MakerPRO知識充電報
與40000位開發者一同掌握科技創新的技術資訊!