邊緣人工智慧(Edge AI)商機升溫,市場競爭焦點正從單一晶片的算力,延伸至感測、推論與連結能力的系統整合。從PC、智慧型手機、智慧車輛到各種智慧物聯網裝置,還有當紅的機器人,都開始需要了解周遭環境,並在裝置端即時反應,因此IC設計業者所面臨的挑戰也從「能否執行AI模型」,轉變為如何在功耗、記憶體、成本與模型快速演進之間取得平衡。
Edge AI領域的半導體產品和軟體IP授權廠商Ceva於11月初舉辦年度技術研討會,邀集技術團隊、客戶與生態系夥伴,探討實體AI、裝置端推論及新一代無線連結。對這家以無線連結與DSP IP建立市場基礎的公司而言,AI帶來的機會,正在於協助客戶將既有連網裝置,升級為能夠感知環境、自主判斷的智慧系統。
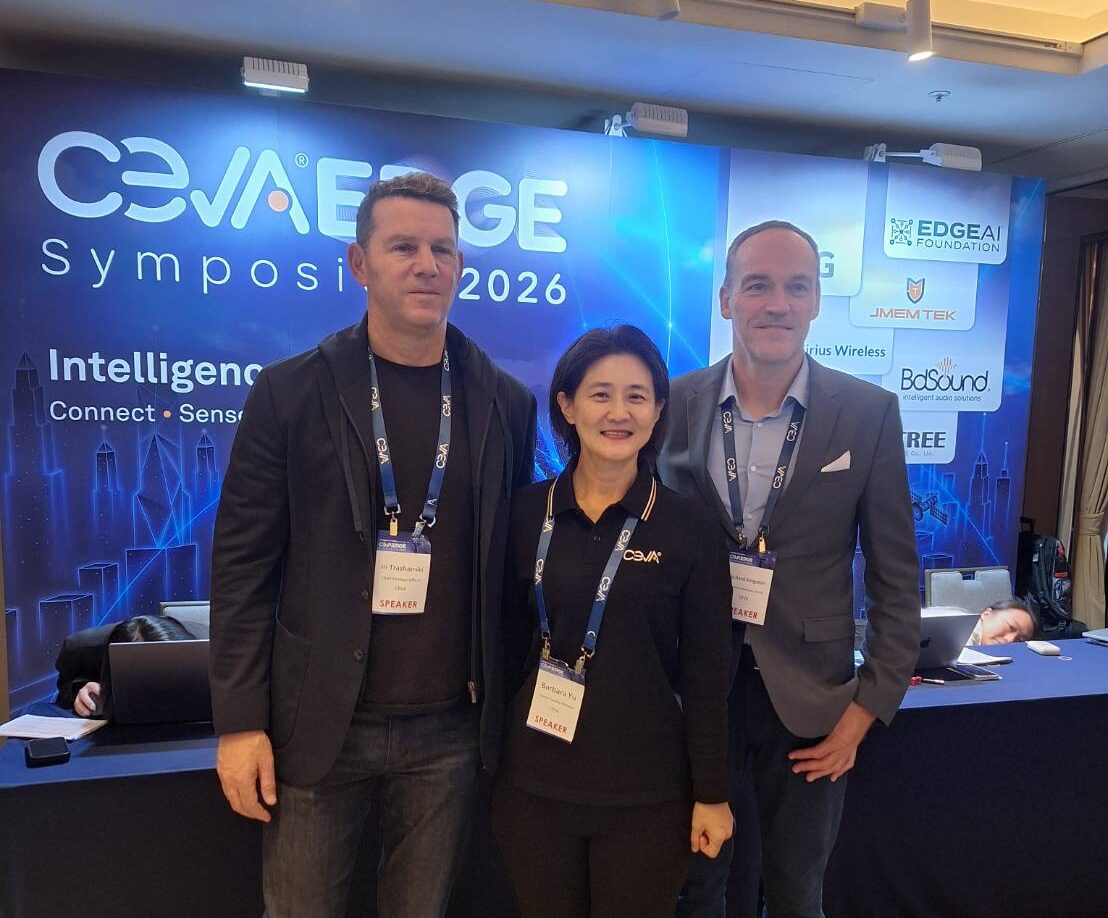
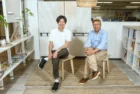
Ceva於11月初於新竹舉辦年度技術研討會,由(左至右)策略長Iri Trashanski、台灣區總經理于長艷,以及市場情報、投資人關係暨公共關係副總裁Richard Kingston共同主持。(攝影:Judith Cheng)
實體AI帶來新挑戰 設計重心轉向系統效率
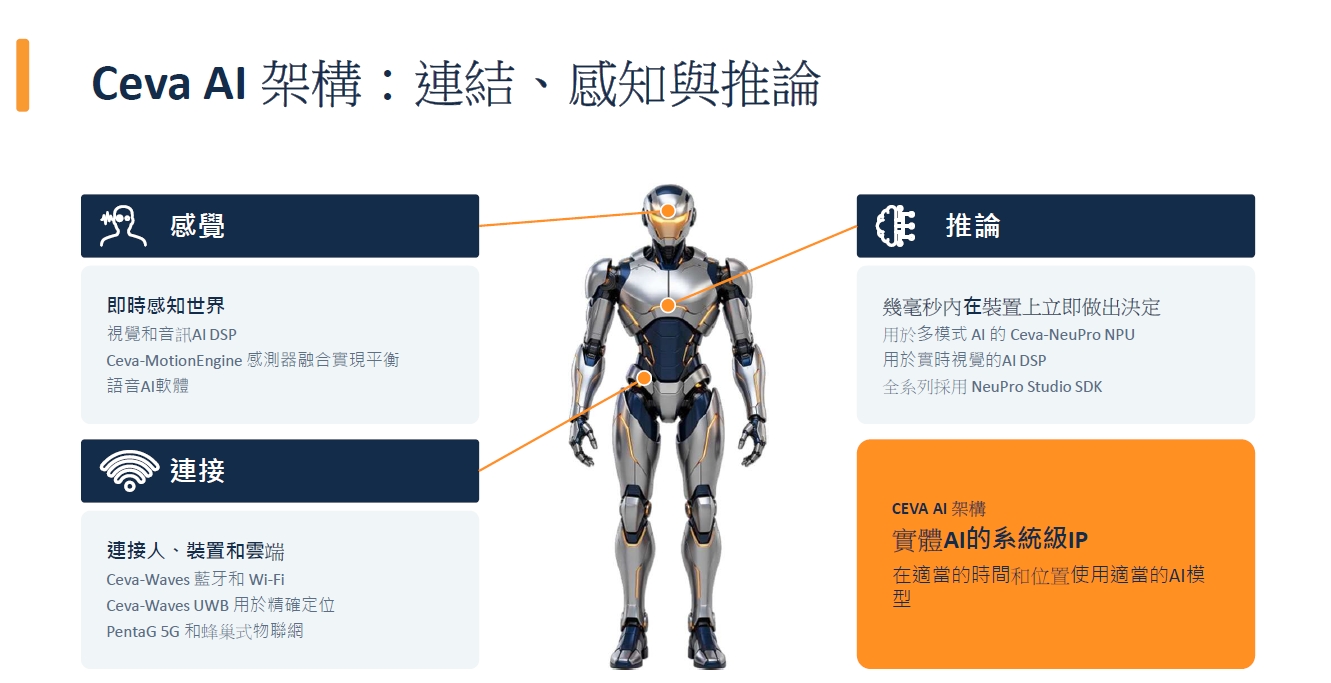
從嵌入式系統、IoT走向Edge AI,IP供應商與客戶的合作出現哪些改變?Ceva策略長Iri Trashanski指出,裝置必須同時具備感知、推論與連結能力,才能理解環境並採取行動;不同模型與AI代理,也可能分布在終端、閘道器與雲端,必須依任務配置資源。
「我們認為應該在正確的時間、正確的位置,使用合適的引擎;」Trashanski舉例指出,穿戴裝置的常時感測與喚醒詞辨識,適合由低功耗引擎處理;較複雜的模型則可交由手機、閘道器或雲端執行。若將過大的運算引擎放進小型裝置,耗電與散熱便可能成為問題。
Ceva的市場情報、投資人關係暨公共關係副總裁Richard Kingston則以人形機器人為例指出,系統需要透過視覺、聲音與動作感測取得資訊,再於本地端完成即時分析。「當這些資料進入人形機器人時,你需要AI能力,在機器人內部即時處理資訊;」他強調,需要即時回應的工作,不能完全依賴將資料送往雲端處理。
(圖片來源:Ceva)
Ceva將這些需求整合為「AI Fabric」布局,結合AI DSP、MotionEngine感測器融合軟體、NeuPro NPU及無線連結IP,支援實體AI的系統設計。
四款NPU共用架構 延續模型與軟體投入
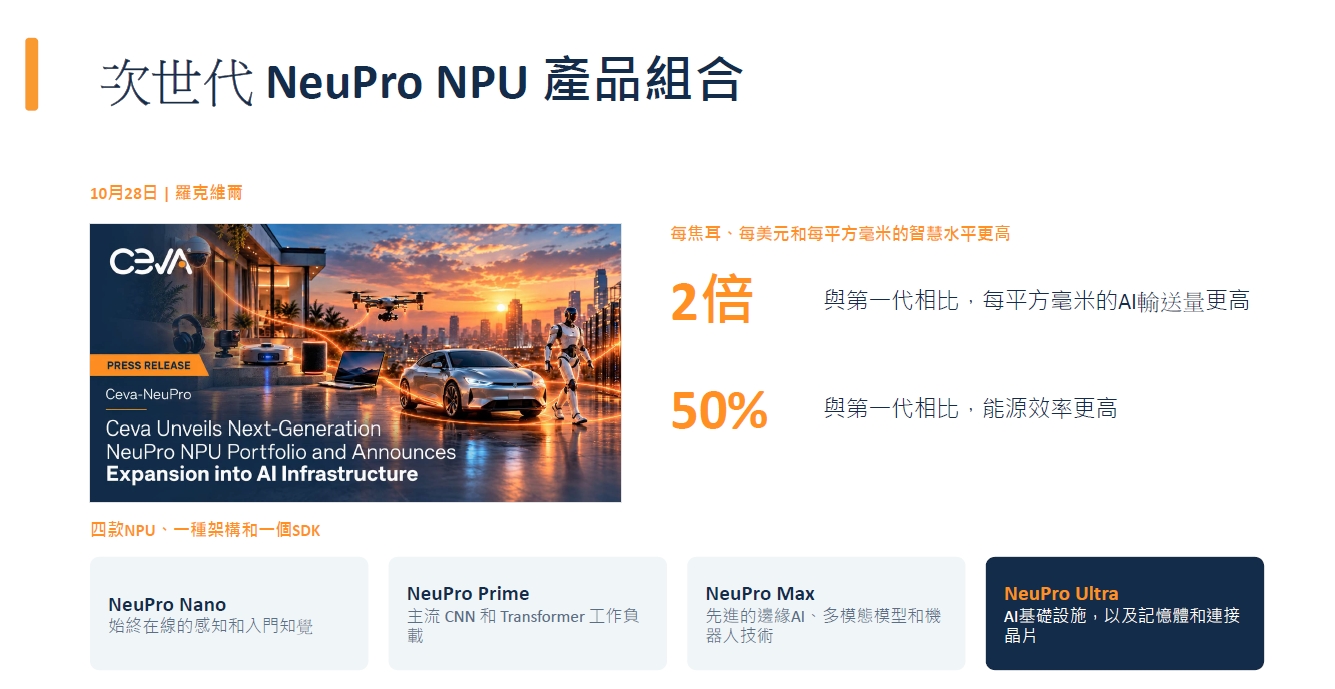
針對不同運算規模,次世代NeuPro分別以Nano、Prime、Max與Ultra四個系列,分別涵蓋常時感測、主流CNN與Transformer、進階多模態與機器人,以及AI基礎設施應用,並共用NeuPro Studio SDK。
「效率不只是功耗,也包括模型效率;」Trashanski指出,量化、壓縮與模型最佳化可以降低資源需求,硬體須提高每瓦、每平方毫米的有效處理能力,系統端則要減少資料搬移與記憶體存取負擔。根據Ceva的官方數據,新架構每平方毫米AI輸送量最高可達前代兩倍,能效提升50%。
(圖片來源:Ceva)
AI模型的更新速度遠快於晶片開發週期,也讓架構彈性成為關鍵。「每天都有新模型出現,要如何讓部署真正變得簡單而有效率?」Trashanski表示,客戶需要的不只是當下能跑得動模型,更希望產品上市後仍能支援新的應用,因此架構設計必須預先考量模型演進。
不過,可擴展性也有硬體界線。「你無法讓同一顆10 TOPS晶片變成400 TOPS,可能仍然需要開發新的晶片;」他在問答中補充指出:共通架構的價值,在於讓客戶開發下一代產品時,延續既有SDK、工具與部署經驗;既有晶片則可透過模型最佳化改善效率,擴大可支援的功能。
與夥伴共同打造量產AI晶片 授權IP與自研NPU共同分工
Ceva分享了與韓國AI晶片設計業者Mobilint合作打造的REGULUS邊緣AI SoC案例,Kingston指出,該SoC提供超過10 TOPS算力,功耗低於3W,並已應用於Mobilint的MLD-R1 AI加速器,成為NeuPro NPU系列首個量產部署案例。REGULUS同時整合Mobilint自研NPU、Ceva NeuPro Nano與SensePro AI DSP,顯示授權IP與客戶自行開發的架構,可以在同一系統中分工。
「Mobilint也有自己的NPU,因為他們擁有自身的強項與能力;」Kingston表示,客戶自研引擎通常針對特定工作負載最佳化,但若要增加常時運作功能,或支援其他神經網路,仍可能需要較小且具彈性的引擎。他認為,將這類IP與內部開發成果結合,有助於兼顧既有專長與新應用需求。
汽車市場也呈現從設計導入走向實際產品的進展。Ceva表示,其AI DSP與加速器透過瑞薩R-Car V4H平台,應用於2026年式Toyota RAV4。從低功耗裝置到車用視覺,這些案例反映AI運算需求正依應用形成多樣化分工。
與CPU平台協作 從應用需求決定運算組合
面對CPU與NPU整合平台的競爭,沒有自家CPU的Ceva如何維持優勢?Trashanski表示,既有NeuPro客戶多數採用Arm CPU,雙方在系統內分工。「我們將Arm視為合作夥伴,並與他們共同合作;」他指出,CPU與NPU透過共通匯流排交換資料,Ceva的重點是提供符合應用需求的高效率推論引擎。
同樣的思維也適用於MCU。Trashanski指出,MCU具有成熟軟體與開發基礎,但部分AI工作若單靠提高時脈執行,可能增加耗電,仍難滿足回應時間要求。「你必須找到合適的組合,這又回到了效率的問題。」他認為,加入適當規模的NPU,是為了在效能、延遲與電池壽命間取得平衡。
這意味著,晶片設計必須從實際工作負載出發,決定CPU、DSP、NPU與記憶體的組合。單看峰值算力,已難以判斷一套架構是否適合目標產品。
客戶合作加深 IP交付延伸至模型與量產支援
模型與應用持續變化,也讓IP供應商的角色延伸至更長的開發流程。Kingston表示,Ceva與第一代NeuPro超過15家授權客戶合作,累積不同市場的需求,再將運算、記憶體、頻寬與成本方面的經驗回饋至次世代架構。
「這些與第一代客戶合作的經驗,讓我們更了解客戶下一步真正需要什麼;」Kingston補充指出,從IoT、PC到資料中心,不同市場的設計要求,有助於Ceva調整架構與產品方向。
合作對象也從晶片設計團隊,延伸至系統與軟體業者。Trashanski表示,Ceva正與軟體及AI平台團隊合作,從應用需求出發規劃晶片能力;同時結合Sensory、embedUR與BdSound等夥伴,提供模型及應用軟體,協助客戶將運算引擎轉化為語音、聲學感知與其他產品功能。
合作加深也增加支援需求。「AI業務愈成功,我們就需要更多人來支援這些客戶;」Kingston坦言,高階AI工程人才的競爭對象包括大型科技公司。隨著設計導入增加,Ceva必須同步擴充工程支援,才能確保客戶順利完成產品開發。
從連結子系統到AI基礎設施 整合能力決定價值
Ceva也將平台思維延伸至連結業務,透過Ceva-Waves Links整合無線數位IP、射頻與軟體,減少客戶自行組合與驗證的負擔,讓研發資源能投入產品差異化。「對我們來說,連結技術是將AI帶給既有客戶的入口;」Kingston表示,許多業者過去已採用Ceva的Bluetooth、Wi-Fi或DSP技術,當產品需要增加本地推論能力時,既有合作關係便有助於拓展NPU的導入機會。
NeuPro Ultra則將布局延伸至AI基礎設施。Trashanski說明,客戶可將其用於客製化推論加速器,也能整合至記憶體、連結及資料處理子系統。Kingston補充,部分客戶正研究以神經網路取代既有演算法,例如改善資料路由與傳輸延遲,讓AI在系統背後提高運作效率。
當開源模型與硬體選項增加,商用IP的價值也更需要透過產品成果證明。「開源可以提供IP,但你要如何整合、最佳化,並讓它成為真正能交付產品的子系統?」Kingston指出,Ceva希望提供的,是從授權到晶片上市的持續合作,協助客戶降低開發風險。
對台灣IC設計業者而言,Edge AI的機會將取決於能否把模型能力,轉化為功耗與成本可負擔、且能持續更新的產品。IP供應商的競爭,也將進一步落在架構彈性、軟體生態,以及與客戶緊密合作完成系統設計與量產的能力。
本文同步刊登於合作夥伴媒體 Silicon Press|矽島通訊社,歡迎關注!
- 從連網走向自主智慧 Ceva以系統級IP布局實體AI - 2026/11/09
- EDGE AI Taipei 2026:串聯全球生態系、拓展邊緣AI商機 - 2026/10/28
- 代理式AI帶動CPU需求 Intel以開放生態布局資料中心商機 - 2026/10/06
訂閱MakerPRO知識充電報
與40000位開發者一同掌握科技創新的技術資訊!