在人工智慧迅速發展的浪潮中,大型語言模型(LLM)的算力需求與一般個人的硬體配備之間,始終存在著一道難以跨越的溝通溝壑。長期以來,擁有上千億參數的旗艦級 AI 模型,幾乎是雲端巨型伺服器集群的專利。個人使用者若想在在地端運作這些高智力模型,往往面臨顯示記憶體(VRAM)瞬間爆滿的尷尬困境。
然而,全新的開源本地推理引擎 Strata 帶來了突破性的轉機。Strata 是一款突破性的開源本地 AI 推論引擎,推論引擎就是「把訓練好的模型拿來回答問題」的程式。Strata專為在消費級個人電腦上運行超大規模混合專家模型(MoE)所設計。過去這類旗艦級模型往往需要幾十萬甚至上百萬的高昂企業級伺服器集群才能驅動,而 Strata 徹底打破了這一硬體牆。
Strata 專門用來在家用電腦上執行 Qwen 團隊的 Qwen3.8-Flash-Next。這個模型有 1250 億(125B)個參數,壓縮到 2 位元後的檔案仍有 66 GB 左右,平常要放在伺服器上跑。搭配多 Token 投機解碼(Speculative Decoding),現在只需一張 12GB~16GB 顯存的消費級顯卡(搭配 64GB+ 系統記憶體),就能跑出高達數百 tokens/s 的實用速度,讓個人開發者也能零 API 成本、在地端掌控旗艦級 AI 智力。
它藉由極致的軟硬體協同優化,成功讓一般消費級顯示卡與個人電腦也能順暢駕馭過去不可想像的巨型模型。本文將深入剖析 Strata 的技術奧秘、拆解 LLM 底層運作的核心關鍵,並針對當前主流硬體配備提供全面評析,為想要探索本地 AI 的讀者提供完整指引。
突破「VRAM 高牆」:Strata 的技術架構與運作邏輯
傳統推理引擎在面對超出顯存容量的模型時,普遍採用簡單粗暴的層級卸載方式。一旦顯存裝不下,就把剩下的神經網路層推給系統記憶體(RAM)處置。這種作法會讓數據在 PCIe 匯流排上頻繁搬運,形成嚴重的傳輸瓶頸,導致文字生成速度斷崖式下跌。
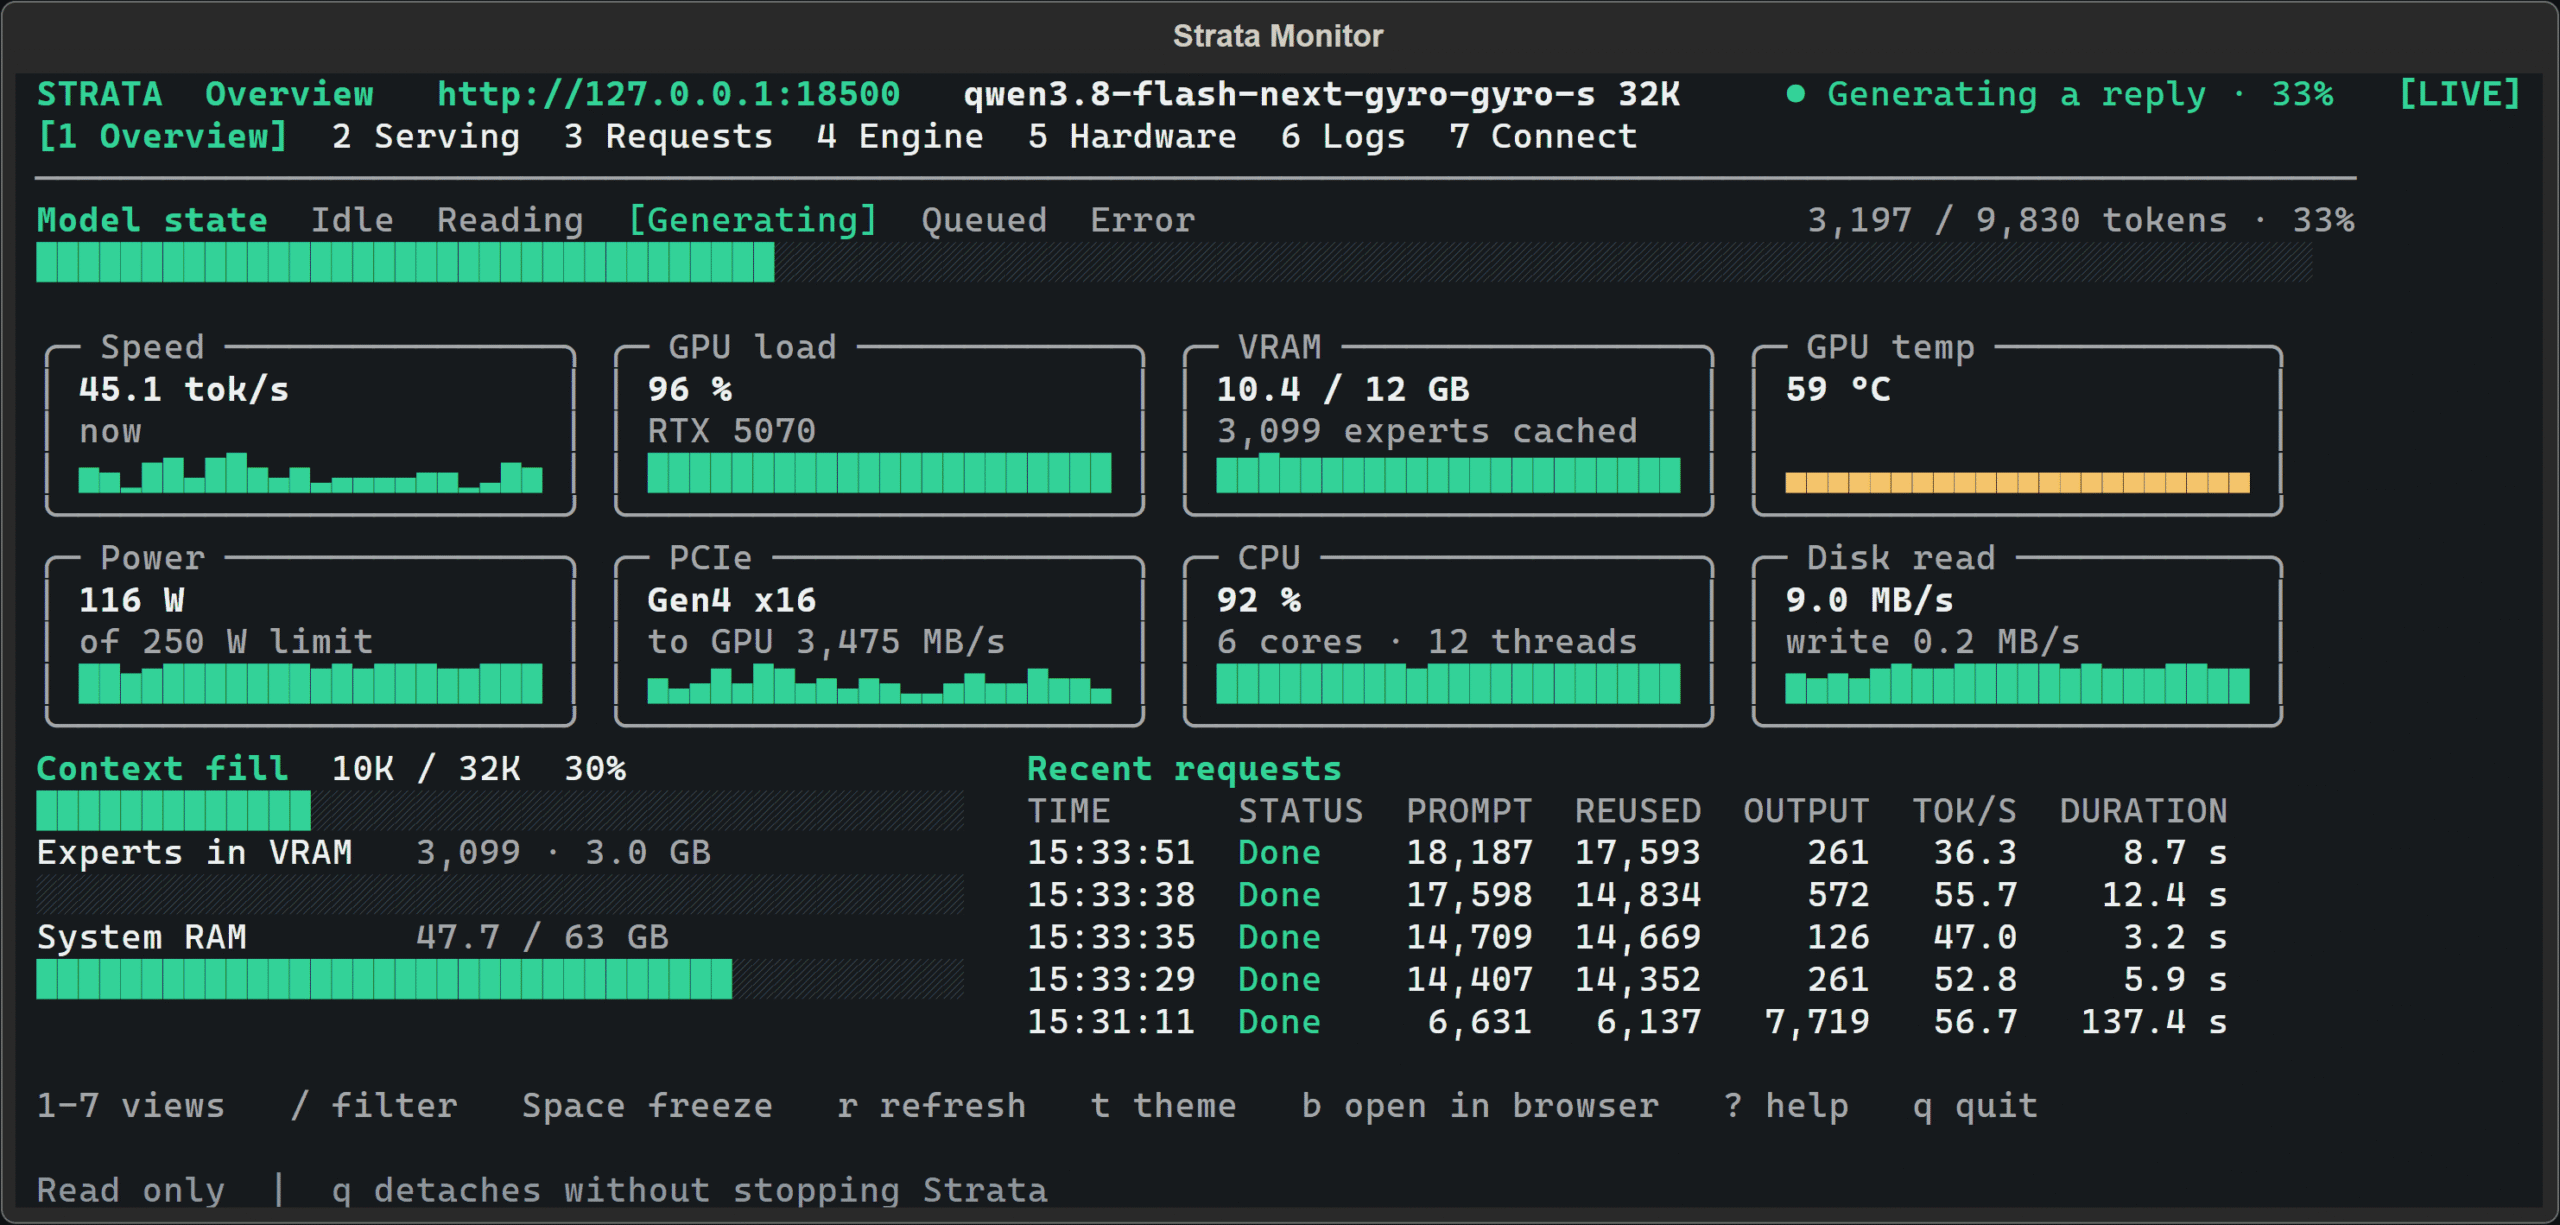
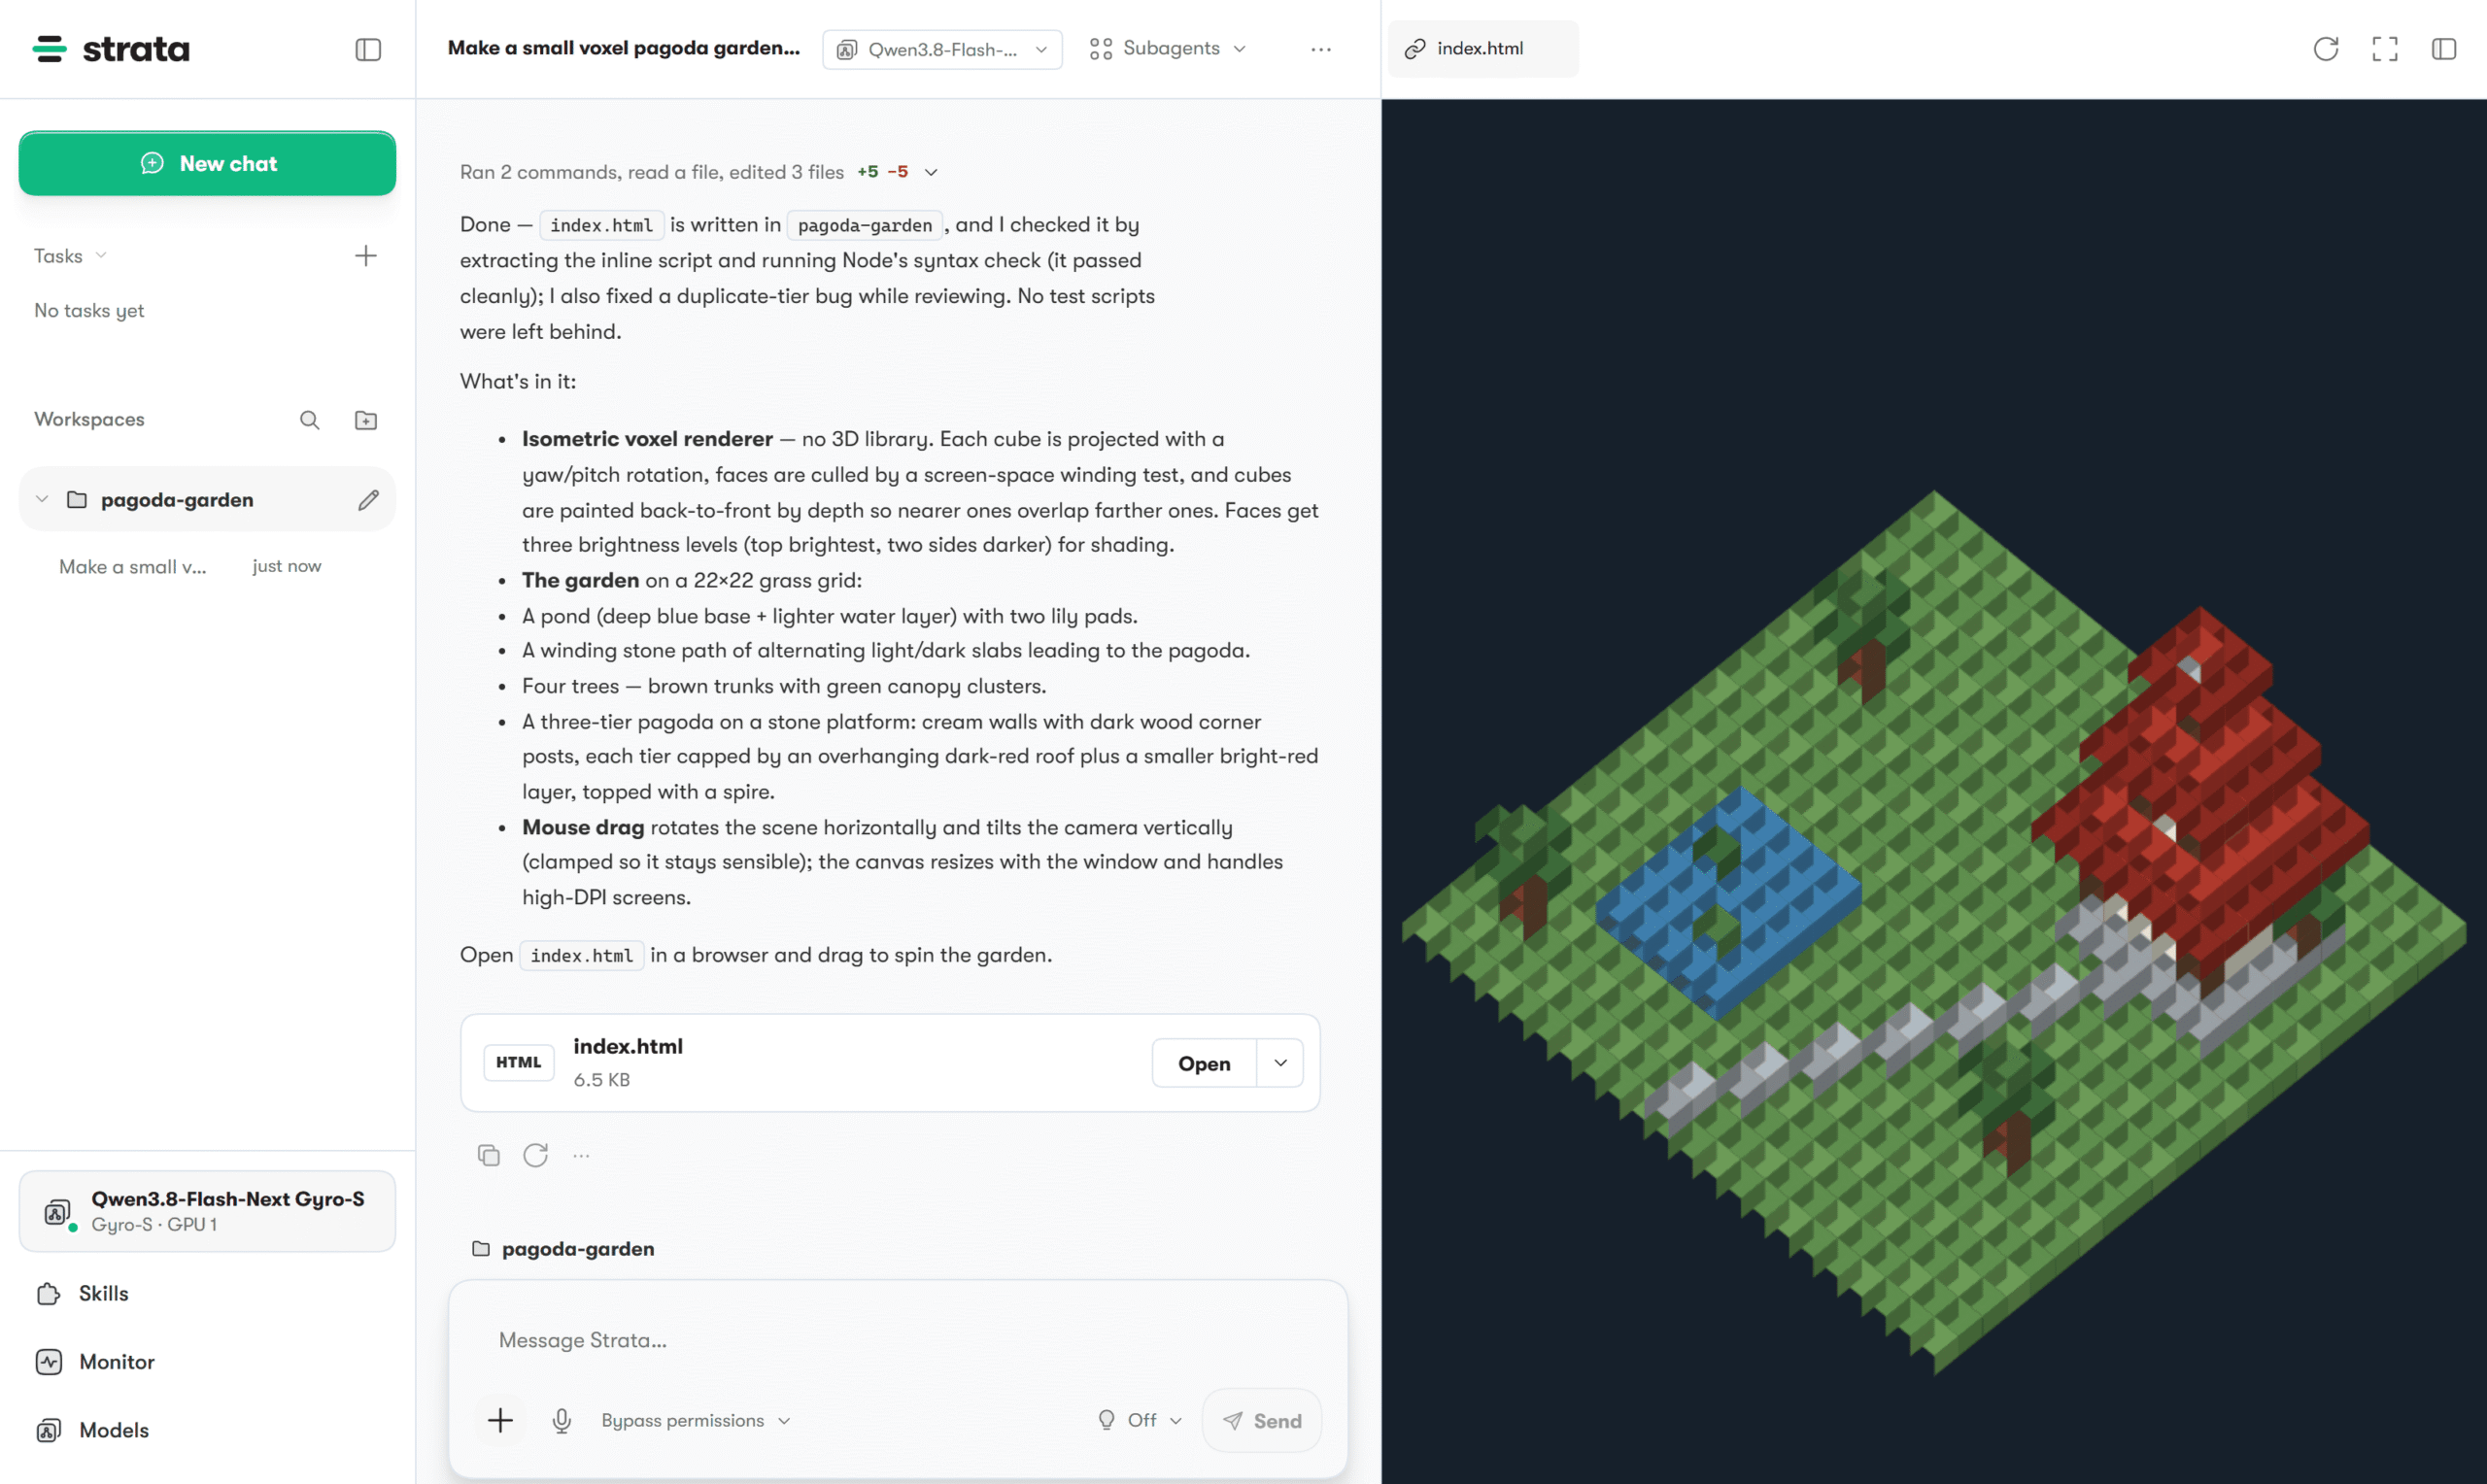
Strata運行期間的介面,可觀察你的模型和硬體狀態 (source)
Strata 則徹底拋棄了這種傳統思維,專為混合專家模型(MoE)的稀疏激活特性設計了一套異構動態管理機制。在包含數以萬計專家的巨型 MoE 架構中,雖然模型總參數龐大,但生成每一個字詞時,實際上只有極少數的專家處於運作狀態。Strata 巧妙地將硬體資源規劃為三層分級架構:顯存專門存放注意力機制、KV Cache 以及最常被呼叫的熱門專家快取;系統記憶體則作為完整的專家備用資料庫;而固態硬碟則負責儲存超大型尋找表,透過隨機讀取技術按需存取。
更為精妙的是其動態協同與預測機制。Strata 在計算當前字詞的同時,會提前預測後續可能被觸發的專家,並利用非同步傳輸將權重提前拉入顯存。倘若出現快取未命中的極端狀況,Strata 也不會讓顯示卡空轉等待,而是啟動 CPU 與 GPU 的雙軌平行計算——GPU 繼續處理顯存內的資料,CPU 則同步在記憶體中計算未命中的冷專家,最後再將兩者結果加權合併。這種設計抹平了傳輸造成的延遲卡頓,讓個人電腦也能展現出令人驚豔的推論效率。
主流推理引擎綜合評析
為了更清晰地瞭解 Strata 的技術定位,將其與目前開源社群中廣受歡迎的 Ollama 及 vLLM 進行對比,有助於評估不同情境下的最適選擇。
| 評比維度 | Strata | Ollama (llama.cpp) |
vLLM |
|---|---|---|---|
| 定位與核心目標 | 專為個人電腦運行超大 MoE 模型打造 | 開箱即用,注重跨平台與極佳普及度 | 企業級高併發生產環境首選 |
| 記憶體調度機制 | 顯存/記憶體/硬碟三層動態分級與專家快取 | 按模型層級硬性切分至顯存或系統記憶體 | 偏好完全載入顯存,支援多卡張量平行 |
| 模型相容性廣度 | 較為專一,深耕特化 MoE 架構 | 極為廣泛,支援上千種通用 GGUF 模型 | 廣泛,支援 Hugging Face 主流模型 |
| 超大模型(顯存溢出)效能 | 表現極優,仍可保持流暢生成速度 | 速度顯著下滑,受限於記憶體傳輸 | 無法運作,顯存不足時直接報錯 |
| 多請求併發能力 | 偏向單人單一請求優化 | 支援基礎多請求,但擴充性有限 | 極高,配備連續批處理技術 |
從比較中可以看出,Ollama 憑藉極高的相容性與易用性,依然是日常輕度使用的最佳入門工具;vLLM 則以強大的併發處理能力霸佔企業伺服器市場;而 Strata 則在「單人使用超大模型」這條賽道上開闢了全新可能,成為追求極致智力表現者的利器。
關鍵密碼拆解:什麼是 KV Cache 與 Expert?
要理解 Strata 如何實現如此強大的調度能力,就必須先釐清大型語言模型推論中的兩大核心組件:KV Cache 與 Expert(專家)。
KV Cache 是語言模型在生成文字時,用來避免重複計算的記憶體快取技術。模型在產生回應時是以「逐字生成」的方式推進,每一個新字詞都需要參考先前產生的所有上下文。若無快取機制,每產生一個新字,模型就必須將前面數百甚至數千個字詞的 key 與 value 向量重新計算一遍,導致生成速度隨文本變長而急劇變慢。有了 KV Cache 之後,舊字詞的計算結果會被保留在快取中,大幅節省了計算量,但代價則是會隨著對話長度顯著吞噬顯存空間。
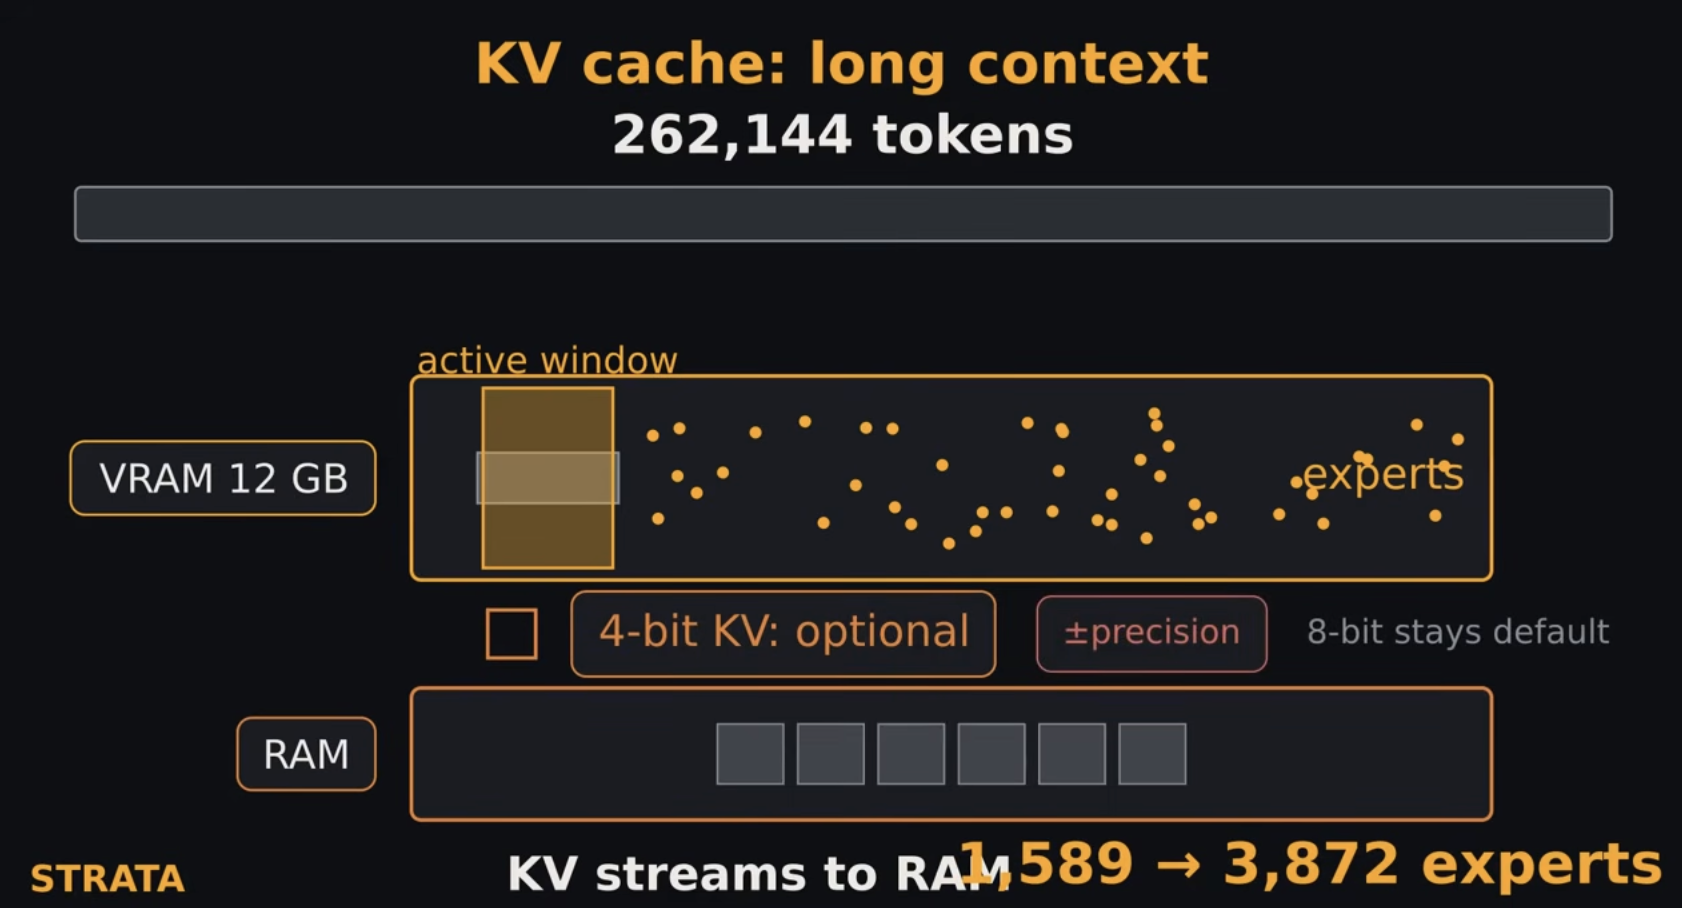
而 Expert(專家)則是混合專家模型(MoE)中的基本計算單元。傳統模型每次計算都需要動用全數神經元,而 MoE 模型則將內部拆分為許多獨立的神經網路(即專家)。當使用者輸入指令時,內部的路由器會精準判斷語意,僅挑選最擅長該主題的少數專家進行計算,其餘專家則維持休眠。這種機制實現了「低計算成本、高智力表現」的優勢。
Strata 的強大之處,正是在於它能同時精細管理這兩者。它在顯存中優先劃分出固定的 KV Cache 區塊以確保對話連貫順暢,並利用剩餘空間建立熱門專家快取;一旦對話變長、KV Cache 膨脹時,Strata 會彈性調整專家快取的比例,將部分冷專家的計算無縫轉移給 CPU 與系統記憶體,從而在避免顯存溢出的同時,最大程度維持回應速度。
硬體選型評估:RTX 5070、3090 與 RX 9070
對於想要建置在地端 AI 環境的使用者而言,顯示卡的選擇無疑是最關鍵的一環。針對市場上熱門的 RTX 5070、RTX 3090 以及 RX 9070,我們可以從硬體規格與實際應用層面進行深入對比。
| 硬體指標 | NVIDIA RTX 5070 | NVIDIA RTX 3090 | AMD Radeon RX 9070 |
|---|---|---|---|
| 核心架構世代 | Blackwell 新世代 | Ampere 經典世代 | RDNA 4 新世代 |
| 顯示記憶體 (VRAM) | 12GB ~ 16GB GDDR7 | 24GB GDDR6X | 16GB GDDR6 |
| 記憶體介面位元 | 192-bit ~ 256-bit | 384-bit | 256-bit |
| 整體運作功耗 | 約 220W – 250W | 350W 以上高功耗 | 約 220W – 260W |
| AI 軟體生態支援 | 完整生態,支援最新 FP4 加速 | 完整 CUDA 生態,廣泛相容 | 支援 ROCm,Windows 生態發展中 |
NVIDIA RTX 3090 憑藉 24GB 的巨量顯存與 384-bit 的高頻寬,至今依然是本地 AI 領域的「長青樹」。在運行大型語言模型或處理高解析度圖像生成時,大顯存能提供極高的安全邊界。然而其較高的功耗與發熱量,則是選購時需要考量的代價。
RTX 5070 則代表了新世代架構的優勢。採用 GDDR7 記憶體與更先進的計算單元,擁有極佳的能效比與最新的 AI 特性支援。雖然顯存容量稍遜於 3090,但在搭檔 Strata 這類具備優異調度能力的推理引擎時,依然能在主流應用中展現出色的綜合體驗,非常適合兼顧遊戲與 AI 創作的使用者。
AMD RX 9070 則在純遊戲效能與價格上展現出優異的競爭力。隨著 RDNA 4 架構大幅提升了光線追蹤與 AI 計算能力,配合 16GB 顯存,在傳統圖像處理與特定 Linux ROCm 環境下均有不錯表現。不過在 Windows 環境下的 CUDA 專屬 AI 工具鏈相容性上,相較於 NVIDIA 陣營仍需要更多設定與調校。
結語
從推理引擎的技術革新到底層機制的精妙設計,再到硬體層面的精準匹配,本地 AI 生態正經歷著前所未有的轉型。Strata 的出現證明了:透過優良的軟體架構設計,能夠有效打破硬體瓶頸,將原本遙不可及的旗艦級 AI 體驗落實到個人電腦之中。對於技術愛好者與開發者而言,理解這些核心技術與硬體特質,將能更從容地打造出專屬於自己的高效能在地 AI 工作站。
(責任編輯:歐敏銓)
》延伸閱讀:
Github: strata launch: set up, serve and watch
Strata 拆解:一張 12 GB 顯示卡怎麼跑 1250 億參數的模型
- 【個人AI革命】解密Strata本地端引擎如何駕馭巨型模型 - 2026/11/12
- 地端AI從模型走向應用 技嘉分享開發與部署實戰經驗 - 2026/11/11
- 恩智浦新推整合式機器人平台 加速可信賴實體AI部署 - 2026/11/10
訂閱MakerPRO知識充電報
與40000位開發者一同掌握科技創新的技術資訊!