在人工智慧從「生成式對話(Generative AI)」加速邁向「自主代理(Agentic AI)」的關鍵轉折點上,軟硬體協同設計的瓶頸日益顯現。過去數年間,開發者往往被迫在「本地端運算資源不足」與「雲端 API 昂貴且隱私受限」之間做出妥協。NVIDIA 與 Microsoft 聯合推出的 RTX Spark 平台,正是為了打破此一雙重困境而生的劃時代產物。
這項技術不僅僅是推出一台新型態的個人電腦,更是將個人運算終端從單純執行指令的「工具」,徹底重構為具備自主感知、推理與執行能力的「個人 AI 工作夥伴」。
本文將從系統架構、混合算力調度、核心技術棧、Agent 應用場景與模型生態系等面向,為 AI 開發者與系統架構師提供全面而深刻的技術導讀。
統一記憶體超級晶片的突破
傳統個人電腦在處理大規模語言模型與多模態任務時,最核心的障礙在於「異構記憶體牆(Memory Wall)」與 PCIe 匯流排的頻寬瓶頸。傳統系統中,CPU 記憶體與 GPU 顯存各自獨立,跨組件資料傳輸極易形成卡頓。RTX Spark 的核心解答,是一顆將 NVIDIA Grace CPU 與 NVIDIA Blackwell RTX GPU 深度封裝在一起的超級晶片。
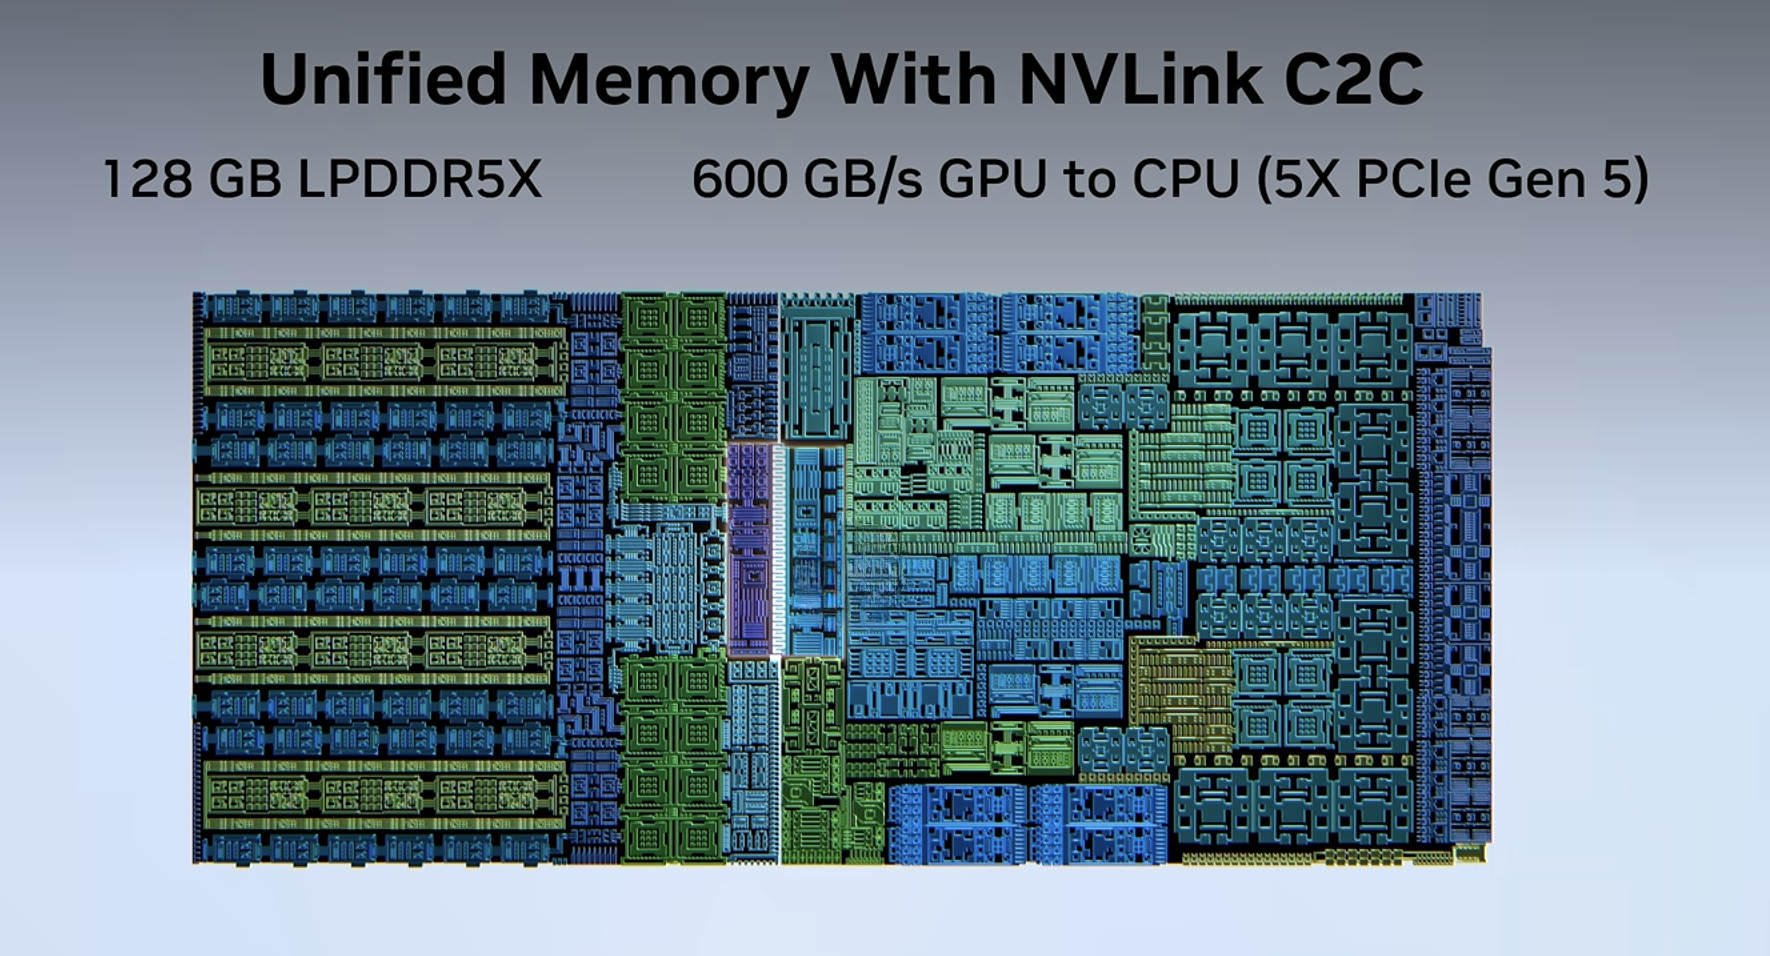
這種整合不僅帶來驚人的算力數字,更徹底重塑了資料流動的路徑。透過 NVLink-C2C 高速互連技術,Grace CPU 與 Blackwell GPU 能以高達雙向 600 GB/s 的頻寬共享高達 128 GB 的統一記憶體。這意味著開發者不再需要精精計較模型參數如何分拆載入顯存,而是能在本地終端直接加載並流暢運行以往必須依賴伺服器級 GPU 才能推動的數百億參數模型。這座硬體橋樑的架設,正式宣告了個人 Agentic AI 時代的來臨。
混合式智慧運算的架構天平
針對 Microsoft 所提出的「將 Windows 打造成混合式智慧運算平台」戰略,開發者需要從系統架構的角度理解本地運算(Local Execution)與雲端卸載(Cloud Offloading)之間的動態平衡。這並非二選一的單選題,而是一套基於工作負載特性進行分流的調度藝術。
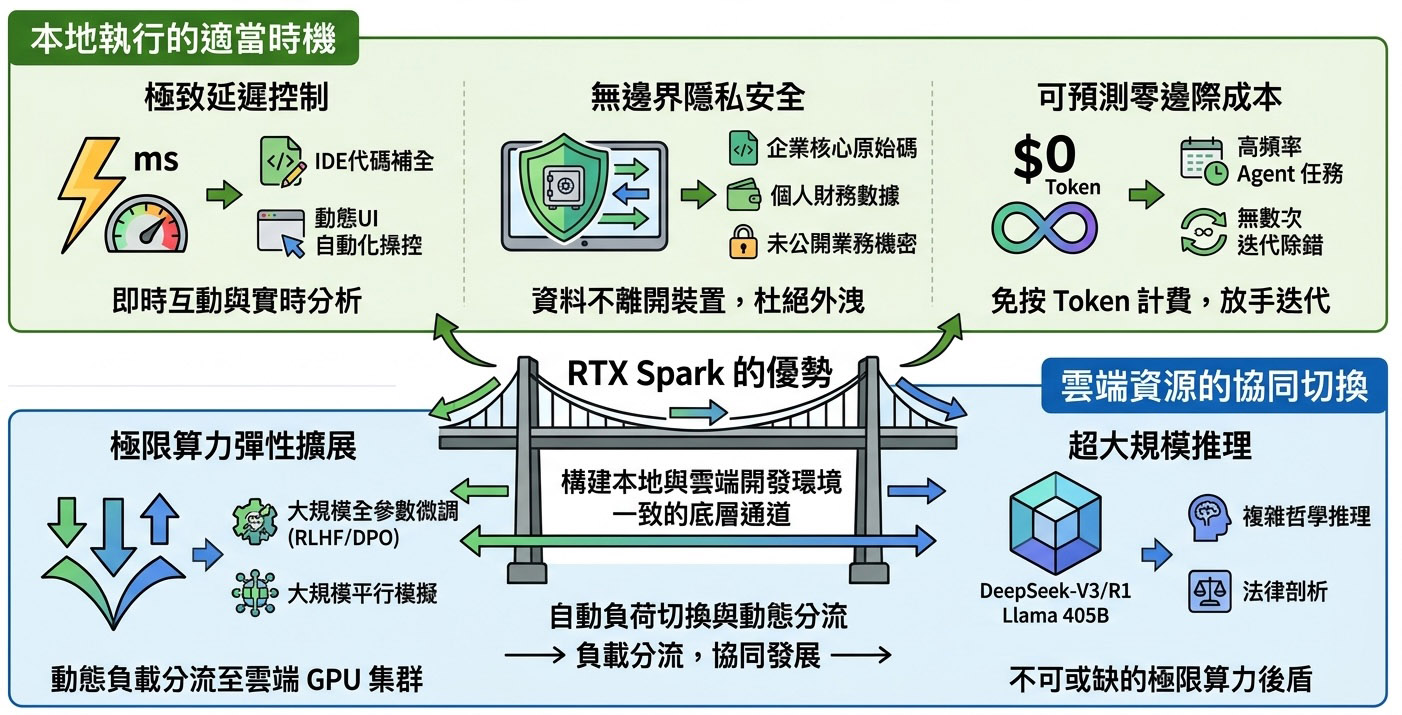
本地執行的適當時機
本地運算的核心優勢在於極致的延遲控制、無邊界的隱私安全以及可預測的零邊際成本。當應用場景涉及即時互動時,例如 IDE 中的自動程式碼補全、動態 UI 自動化操控或是語音與視訊串流的實時分析,本地執行的毫秒級響應是雲端 API 無法比擬的。
此外,在處理企業核心原始碼、個人財務數據或未公開的業務機密時,本地執行能確保資料完全不離開裝置,從源頭杜絕資料外洩風險。對於需要高頻率、多步驟輪詢的 Agent 任務而言,本地端更能免去按 Token 計費的經濟壓力,使開發者能夠放手讓 Agent 進行無數次的迭代嘗試與除錯。
雲端資源的協同切換
相反地,雲端運算的價值則體現在極限算力的彈性擴展。當任務需要呼叫數千億甚至上兆參數的頂級基底模型(如 DeepSeek-V3/R1 全量模型或 Llama 405B)進行極其複雜的哲學推理、法律剖析時,雲端資源仍是不可或缺的後盾。
同理,在大規模數據集的全參數微調、強化學習(RLHF/DPO)訓練,或是需要瞬間啟動數百個並發 Agent 進行大規模平行模擬時,系統會自動將運算負載切換或動態分流至雲端 GPU 集群。RTX Spark 的優勢,恰恰在於它構建了一條讓本地與雲端開發環境完全一致的底層通道。
算力革命:FP4 精度與 Petaflop 級效能的深層意涵
RTX Spark 宣言中最令技術社群震撼的指標之一,莫過於其提供高達 1 petaflop 的 FP4 AI 運算效能。要理解這個數字對 AI 開發者的真正意義,必須深入剖析量化技術與 Tensor Core 架構的演進。
1 petaflop 代表每秒能執行一千萬億次浮點運算。在 RTX Spark 中,這一效能指標是基於 Blackwell 架構的第四代 Tensor Core 搭配 FP4(4-bit Floating Point)微區段量化(Micro-scaling)技術所實現。相較於傳統 FP16 甚至 INT8,FP4 能將模型記憶體佔用降低至原先的四分之一,並大幅提升記憶體頻寬的使用效率。
對於大語言模型的推論而言,瓶頸通常不在於純算力,而是在於預填(Prefill)與解碼(Generation)階段的記憶體頻寬讀取速度。1 petaflop 的 FP4 算力結合 NVLink-C2C 的高頻寬吞吐,意味著在本地運行 700 億參數規模(70B+)的模型時,Prompt 處理與 Token 生成速度能達到每秒數十甚至上百 Token 的實用門檻。這種效能突破,讓 Agent 能夠在毫秒級的時間內完成「思考—行動—觀察(Thought-Act-Observe)」的自主循環,真正讓 Agent 從理論驗證走向日常可用。
生態系技術矩陣:從底層 SDK 到創作引擎
RTX Spark 絕非單純的硬體堆疊,而是 NVIDIA 將過去數年累積的軟體生態系進行深度整合的集大成者。下表完整整理了平台內建的核心技術及其對開發者的實質價值:
| 技術名稱 | 技術架構定位 | 對 AI 與應用開發者的核心價值 |
|---|---|---|
| CUDA® | 底層通用平行計算 API 與開發框架 | 全球 AI 開發的黃金標準,允許開發者在本地無縫編寫、編譯與除錯原生 PyTorch 與 C++ Kernel,部署至雲端無須重構。 |
| TensorRT™ | 深度學習推理優化器與高效能運行時 | 透過層融合(Layer Fusion)、Dynamic Shapes 與 FP4/FP8 量化編譯 Engine,大幅降低記憶體占用並顯著提升推論吞吐量。 |
| OptiX™ | 光線追蹤(Ray Tracing)硬體加速 API | 為 AI 生成合成數據(Synthetic Data)、3D Agent 視覺感知與空間運算提供光學級別的硬體渲染支持。 |
| DLSS | 深度學習超級採樣與幀生成技術 | 利用 Tensor Core 進行畫質重建與補幀,讓端側能在低功耗下輸出極高品質的 3D 視覺與動態生成介面。 |
| Reflex | 動態系統延遲最佳化 SDK | 精確控制 CPU 與 GPU 的渲染佇列,確保視覺/UI 操控型 AI Agent 在即時擷取畫面與模擬點擊時具備最低延遲。 |
| G-SYNC® | 顯示器更新率動態同步技術 | 消除 AI 即時繪圖、動態生成影音與 3D 測試過程中的畫面撕裂,提供極致流暢的視覺調適環境。 |
| NVENC / NVDEC | 專屬 AV1/H.265/H.264 影像編解碼硬體引擎 | 讓視覺 Agent 能以近乎零 CPU/GPU 占用率的方式,即時解碼並分析多路高畫質螢幕串流與視訊輸入。 |
本地 Agent 實作範例:Hermes 與 OpenClaw 的工作流程
為了更具體地展現個人 Agent 在本地運作的威力,我們可以構建一個「自動化代碼庫重構與單元測試」的真實應用場景。
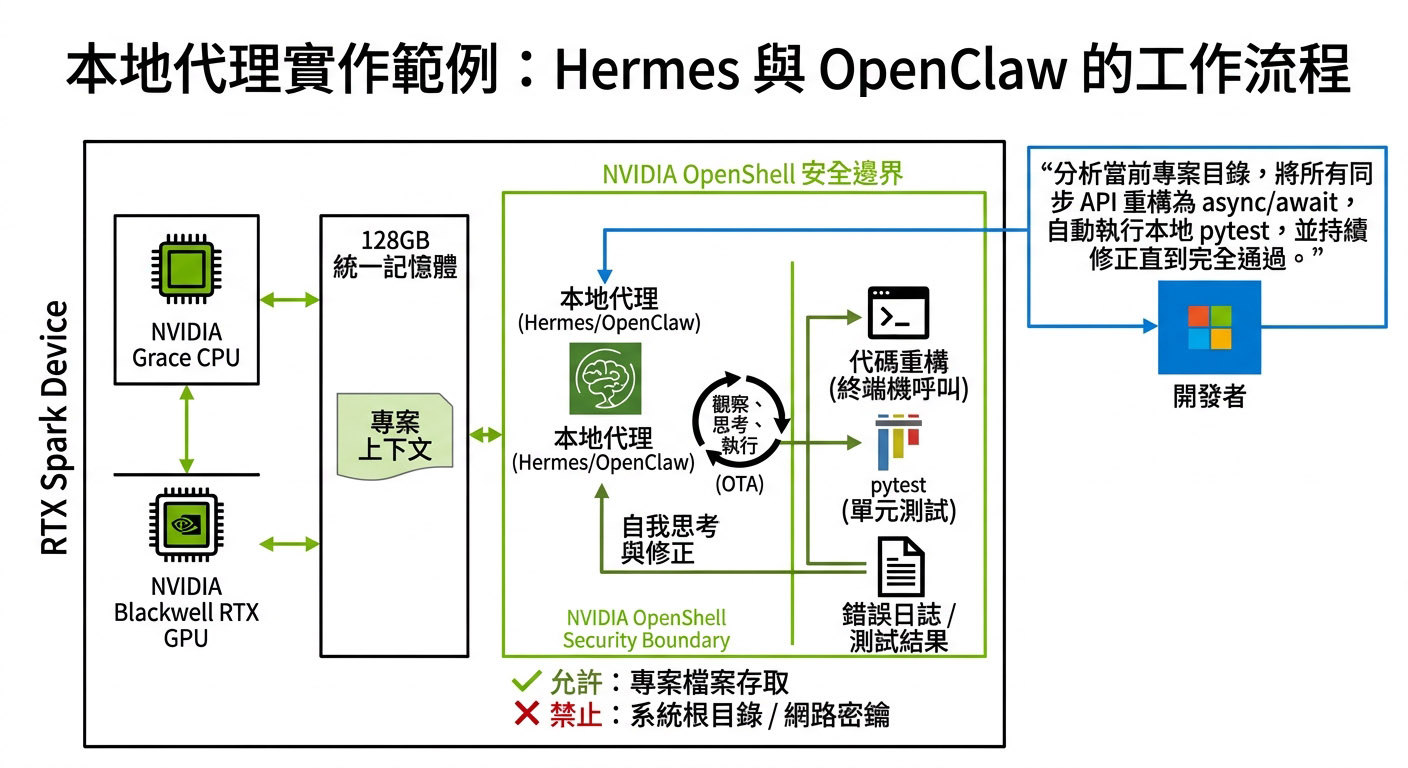
假設開發者需要將一個龐大的舊版 Python 專案重構為全新的非同步架構。在傳統雲端開發模式下,開發者必須將整個專案打包上傳至雲端 API,不僅面臨專案資安外洩的風險,更可能因為 Token 限制而無法一次載入完整的專案脈絡;若使用傳統端側小模型,又常因推理能力不足而產生無效的語法錯誤。
在 RTX Spark 環境下,開發者可以直接啟動部署於本地的 Hermes 或 OpenClaw Agent。開發者僅需下達一句高階指令:「分析目前的專案目錄,將所有同步 API 重構為 async/await 模式,並自動執行本地 pytest,若有報錯則持續修正直至完全通過。」
此時,Agent 會在本地 128GB 統一記憶體中載入整個專案的 Context。透過原生 Python 與 Conda 環境,Agent 自行呼叫 Terminal 執行測試,讀取主機回傳的 Error Log,並在本地端進行自我思考與修正。整個過程中,原始碼從未離開過裝置,且開發者可以透過 NVIDIA OpenShell 安全執行環境,精準設定 Agent 的權限邊界——例如允許其修改專案資料夾內的檔案,但嚴禁存取系統根目錄或網路金鑰。這種高度自主且安全受控的工作流程,正是個人 Agentic AI 的終極形態。
模型生態剖析:Nemotron 3.5 Bolt 與多元模型陣容
在模型層面,NVIDIA 特別為 RTX Spark 優化了 Nemotron 3.5 Bolt 74B-A9B 24GB 模型,這款模型展現了極具創意的架構設計。
Nemotron 3.5 Bolt 的架構特性與限制
該模型擁有 740 億(74B)總參數,但在架構上採用了 A9B(Active 9B)的混合專家(MoE)設計。這意味著在每次推論時,系統僅需動態活化約 90 億個參數,從而將計算延遲降低至極致。更重要的是,經過嚴格的 FP4 量化後,整個模型僅需占用約 24GB 的記憶體空間,在 RTX Spark 上運行的同時,還能留出絕大部分的記憶體資源給其他開發應用程式。
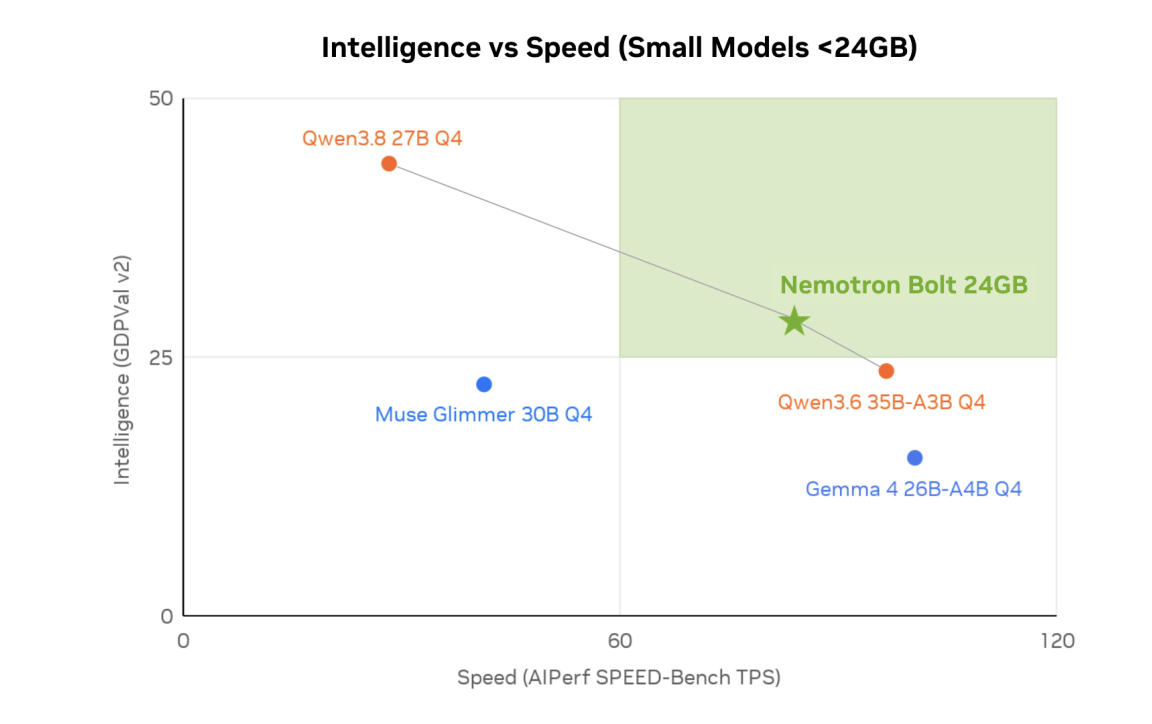
在能力定位上,Nemotron 3.5 Bolt 針對工具呼叫(Tool Calling)、結構化 JSON 輸出以及多步驟邏輯推理進行了深度精調,是目前端側執行 Agent 任務表現最強悍的模型之一。然而,開發者也需理解其架構限制:當面對極端超長文本(如 128k+ Tokens)時,其 KV Cache 仍會產生不小的記憶體開銷;此外,在缺乏 RAG(檢索增強生成)技術輔助的情況下,9B 的活化參數在處理極度冷門的專業領域深層知識時,零樣本推論的能力依然有其物理極限。
多元開放模型選擇
除了 Nemotron 之外,RTX Spark 開放的 CUDA 生態讓開發者擁有完全的模型選擇自由。開發者可以隨時切換至 DeepSeek-R1-Distill 系列進行複雜的數學與程式碼推理,亦可載入 Qwen2.5-Coder (32B/70B) 進行極致的代碼生成,或是運行 Llama 3.3 (70B) 處理解析任務。對於追求極致響應速度的輕量級場景,Phi-4 或 Gemma 2 等模型更能提供近乎瞬時的推論體驗。
數據解密:1.5 億台 RTX AI PC 的市場戰略
NVIDIA新聞稿中提到「具備將成果部署至超過 1.5 億台 RTX AI PC 的途徑」,這一驚人數據對於開發者而言意味著龐大的商業潛力與技術相容性保障。
這 1.5 億台的數據,並非指 RTX Spark 單一裝置的銷售目標,而是 NVIDIA 自 2018 年推出 Turing 架構(GeForce RTX 20 系列)以來,全球已售出並正在運作中、配備有 Tensor Core 的 RTX 繪圖卡(包含桌上型獨立顯卡、電競筆電與專業工作站)的累積安裝基數(Installed Base)。
這項數據背後的戰略意義在於:開發者在 RTX Spark 這台便攜裝置上,利用原生 CUDA、PyTorch-CUDA for Windows on Arm 以及 NVIDIA Skills 所開發出來的 Agent 應用程式,並不是只能封閉運行在特殊硬體上的實驗品。這套應用能夠無縫向下相容並擴展部署至全球廣大的 RTX AI PC 生態圈中。RTX Spark 為開發者提供了最佳的原型製作與測試平台,而全球 1.5 億台 RTX 裝置則成為了其強大的潛在市場。
結論
RTX Spark 的誕生,標誌著個人 AI 運算進入了全新的成熟期。透過將 Grace CPU 與 Blackwell GPU 整合為統一記憶體架構,配合 Windows on Arm 對 PyTorch-CUDA 與 Python 原生生態的全面支援,NVIDIA 與 Microsoft 成功的將以往繁瑣、分散於雲端與本機之間的開發鏈結,壓縮至一台可以放入肩背包的便攜裝置中。
從編寫程式碼轉向「指揮代理程式(Directing Agents)」,開發者不再需要花費大量精力在環境配置、雲端 API 成本控管與資料隱私權衡上。RTX Spark 提供了一個兼具極致效能、安全隔離與全球生態相容性的個人工作站,讓個人開發者也能擁有過去只有大型科技企業才能企及的 Agent 開發與部署能力。
(責任編輯:歐敏銓)
》延伸閱讀:
-
NVIDIA RTX 開發者專區獲取最新 RTX 加速 SDK、TensorRT 庫與原生工具鏈。
-
NVIDIA Skills 開源 GitHub 儲存庫探索如何透過開放原始碼教導 Agent 自動調用 CUDA-X 工具與函式庫。
-
TensorRT-LLM 端側部署與量化指南深入了解大語言模型在 RTX 端側進行 FP4/FP8 量化與 Engine 編譯的具體技術細節。
-
Microsoft Windows AI 開發者中心掌握 Windows Subsystem for Linux (WSL)、Windows Developer Config 與 Windows on Arm 的最佳開發實踐。
- RTX Spark 技術導讀:個人 Agentic AI 開發的系統架構突破 - 2026/10/22
- MIPS工作負載原生平台架構切入實體AI應用發展 - 2026/10/08
- 從高通併購PickNik看科技巨頭的Physical AI技術佈局 - 2026/10/07
訂閱MakerPRO知識充電報
與40000位開發者一同掌握科技創新的技術資訊!