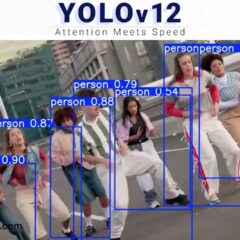
YOLOv12的改變:向Transformer、Attention靠攏!
最新版本 的YOLOv12延續了 YOLO 系列一貫的「高速 + 準確」的設計理念,但在架構、訓練方法與推論效率方面均有顯著改進,並且更加靠近 transformer 技術與多模態學習的整合,本文將做個介紹。
政府半導體業補助課程
最新版本 的YOLOv12延續了 YOLO 系列一貫的「高速 + 準確」的設計理念,但在架構、訓練方法與推論效率方面均有顯著改進,並且更加靠近 transformer 技術與多模態學習的整合,本文將做個介紹。