人工智慧(AI)技術的競爭演進極為迅速,大語言模型(LLM)的賽道已從早期的「字數長度比拚」與「問答聊天」,正式邁入「高階邏輯推理(Reasoning)」與「自主執行(Agent)」的深水區。近期,中國 AI 初創獨角獸月之暗面(Moonshot AI)正式推出了新一代旗艦模型 Kimi K3.1 Pro,在全球科技界引發了高度關注與討論。
這款新模型之所以成為焦點,不僅因為它在長文本處理、複雜程式碼編譯、終端機自動化(Terminal Agent)與 3D 渲染等基準測試中,展現出貼近全球頂級閉源模型 Claude Opus 5.5 的堅實表現,更因為它同時採取了「開放模型權重(開源)」與「超低價格 API」的雙重策略,大幅降低了全球開發者建構高階推理應用(Reasoning App)的門檻。
本文將完整整合 Kimi K3.1 Pro 的技術架構、實測表現、商業價格優勢、營運挑戰,並特別針對台灣開發團隊與企業,提出一套兼顧技術紅利與資安防護的理性應對策略。
技術架構與規格:3 兆參數巨型 MoE 與原生長文本
Kimi K3.1 Pro 作為 K3 系列的最新強化後訓練(Post-Training)版本,在模型底層架構上選擇了當前最前沿的「混合專家架構」(Mixture of Experts, MoE),並針對多步驟邏輯鏈生成與動態算力調配進行了深度優化。
1. 3 兆參數的巨無霸,動態激活維持推論高效
- 總參數量:K3.1 Pro 的整體參數規模高達 2.8 兆至 3 兆。
- 動態激活:雖然整體規模龐大,但在實際推論過程中,系統會根據任務特性僅激活約 1,040 億 參數。這種「專才專用」的 MoE 機制,既保留了巨型模型的知識廣度與思考深度,又兼顧了回應速度與推論效率。
2. 原生100萬Token上下文視窗
月之暗面過去即以「長文本」技術聞名,K3.1 Pro 延續並強化了這一優勢,支援原生 100 萬 Token(約數百萬字)的超長上下文處理。不論是解析整套複雜的企業級代碼庫(Codebase)、閱讀上百頁的跨國法規文件,還是進行長時間的跨表金融研究,都能在單次對話中精確掌握全貌。
3. 模型權重開源計畫
值得注意的是,月之暗面宣布將開放 K3.1 Pro 的模型權重。這意味著它將成為全球開源社群中,參數規模最大且推理能力最頂尖的 MoE 模型之一,為全球研究人員與企業私有化部署提供強大的基礎。
基準測試對比:逼近 Claude Opus 5.5,躋身全球第一梯隊
在權威評測機構 Artificial Analysis(AA)公布的綜合智能指數(Intelligence Index)中,K3.1 Pro 取得了 55 分 的亮眼成績,位居全球前列,與當前市場榜首 Anthropic 的 Claude Opus 5.5(58 分) 差距極小。
為了更精準地了解兩者在真實開發情境中的差異,以下整理了 Kimi K3.1 Pro 與 Claude Opus 5.5 在大型 Codebase 解析、開發環境對接與 API 成本上的實測對比:
表一:Kimi K3.1 Pro vs. Claude Opus 5.5 實測與維度對比表
| 評測維度 / 指標 | Kimi K3.1 Pro | Claude Opus 5.5 | 綜合差異與勝負點解析 |
|---|---|---|---|
| 綜合智能指數 (AA) | 55 分 | 58 分 | 兩者均屬全球第一梯隊,整體差距微乎其微。 |
| Terminal-Bench 4.0 (Terminal / Codebase 自動化) |
65.7% | 66.4% | 旗鼓相當:僅差 0.7%,均展現頂級 Agent 終端操作能力。 |
| 超長 Context 穩定度 (100萬 Tokens 深度檢索) |
極高 (Needle-in-a-Haystack ~100%) |
極高 | 平手:在跨檔案引用與龐大專案樹(Project Tree)追蹤上皆無明顯遺忘。 |
| 複雜環境對接 (Godot / Blender / GUI 腳本) |
92.7% (BenchCAD) |
頂級 | Kimi 著重 3D/CAD 跨域連動;Claude 著重語法語意極致嚴謹度。 |
| 除錯與推理鏈 (CoT) 效率 | 子 Agent 多重遞迴 (Token 消耗較大) |
思考鏈精煉、一次到位率高 | Claude 勝在推論精準度與算力比;Kimi 依賴多重驗證。 |
| API 快取與使用成本 | $1.3 / M Tokens (Cache Hit) |
相對昂貴 | Kimi 顯著勝出,大型 Codebase 重複 Prompt 成本可省 70%+。 |
註:數據資料參考 Artificial Analysis (AA) LLM Benchmarks 與各大公開評測報告。
比較差異深入解析
在處理大型 Codebase 與自動化任務的實測中,兩款模型展現出截然不同的「性格」與優勢:
- Terminal 自動化與環境掌控度(Terminal-Bench 4.0): 在考察 AI 自動操作 Linux 終端機、安裝依賴套件、執行測試與自動修復的 Terminal-Bench 4.0 中,Claude Opus 5.5 以 66.4% 微幅領先 Kimi K3.1 Pro 的 65.7%。Claude 在面對多層嵌套的架構設計時,一次性給出正確認向(First-shot Accuracy)的機率較高;而 Kimi 則展現出極強的「自我修正」能力,能自動在 Terminal 執行錯誤訊息反饋並完成多輪補丁編寫。
- 多模態與 3D CAD 建模(BenchCAD): Kimi K3.1 Pro 在 BenchCAD 拿下 92.7% 的高分,顯示其在處理需要「空間幾何」或「視覺構圖」的專案(如 Godot 遊戲腳本、Blender 自動化渲染、CAD 圖紙轉程式碼)時,跨領域理解力極強。
- 長程金融與商業模組建構: 在金融應用範疇,K3.1 Pro 展現了自主建立複雜財務模型的能力。例如,給定上市公司(如 NVIDIA)的多季財務報表,它能自動完成跨表格公式連動、關鍵指標預測,並產出完整的折現現金流(DCF)估值模型。
價格優勢:快取機制降本 90%,普及高階 Reasoning App
對於開發者與企業而言,模型性能再強,如果 API 調用成本過高,也難以商業化落地。K3.1 Pro 透過高併發架構優化與高效 Prompt 快取(Cache)技術,打破了高階推理模型「貴不可及」的魔咒。
| 計費項目 | 定價 (每百萬 Tokens) | 快取 (Cache) 狀態 | 商業效益與應用場景建議 |
|---|---|---|---|
| 輸入 (Input – 未命中) | 13元 | Cache Miss | 用於全新、無重複背景資訊的單次長文本輸入。 |
| 輸入 (Input – 快取命中) | 1.3元 | Cache Hit | 成本直接砍半再砍半(降至 1/10),適合固定 Prompt、長代碼庫或大型知識庫。 |
| 輸出 (Output) | 68元 | N/A | 用於模型進行多步驟思考(CoT)、工具呼叫與結果生成。 |
快取機制對 Reasoning App 開發的催化作用
高階推理應用(Reasoning App)通常需要模型進行「思維鏈(Chain of Thought, CoT)」推演、自我檢視與工具呼叫(Tool Call)。這意味著輸入與輸出的 Token 數量會呈幾何級數增加。
透過善用 K3.1 Pro 的 Cache Hit 機制(例如將固定系統提示詞、開發框架或大型知識庫預先快取),開發者可將整體運行成本降低 50% 至 70% 以上。這讓許多過去因成本考量而無法落地的多輪自動化 Agent 應用,擁有了大規模商業化的可能。
落地現實挑戰:多層智慧體調度下的算力與額度考驗
雖然 K3.1 Pro 的性能與價格吸引了大量開發者湧入,但在剛上線的前 48 小時內,也暴露出高階推理模型在實際營運中的全新課題。
1. 子 Agent(Sub-Agent)無限遞迴帶來的額度過快消耗
模型發布初期,部分付費訂閱用戶反映「帳戶額度消耗比想像中快許多」,甚至遭遇限流。
- 技術原因解析:高階 Reasoning 模式在處理複雜任務時,後台會自動拆解任務並調用多個子智慧體(Sub-Agent)進行分工思考與反覆驗證。
- 連帶影響:每一次子 Agent 的交互,都會產生大量的背景 Context 與推理 Token。這種「長鏈條自動化思考」雖然提高了最終答案的精準度,但也讓 Token 消耗量以數倍速度暴增。
2. 官方的快速反應與優化方向
針對此一營運痛點,月之暗面迅速採取了雙重措施:
- 補償機制:向全體付費訂閱會員補償 25% 的月度額度。
- 算法架構調整:緊急調優後台排程機制,削減不必要的子 Agent 遞迴呼叫,並動態控制無效的思考輸出長度,在維持回答品質的前提下,大幅提升了推理效率與服務穩定度。
台灣開發者的思考:如何理性看待與導入該技術?
面對具備中國背景但又選擇「開源(Open Weights)」的頂級模型 Kimi K3.1 Pro,台灣開發者與企業團隊不需要陷入非黑即白的抉擇,而是可以採取「技術實用主義」與「資安架構分級」的角度來審視與佈局。
1. 開源帶來最大紅利:掌控權在自己手中
「支援開源」是看待這個技術最關鍵的轉折點。
- 可地端化部署(On-Premise):傳統上使用中國背景的閉源 API,最大的隱憂是資料傳輸至境外伺服器,可能面臨隱私洩漏與資安審查風險;但 Kimi K3.1 Pro 開放模型權重後,台灣企業可以將其下載至企業內部的 GPU 伺服器或在地私有雲(如 AWS Taiwan / GCP 台灣機房)中運行,資料完全不出境。
- 免受斷連與政治風險威脅:閉源 API 隨時可能因為地緣政治因素、法規變更或廠商策略而對特定區域切斷 API 存取;擁有開源權重意味著擁有技術自主權,即便是地緣政治升溫,已下載的模型模型依然能長期穩定運作。
2. 商業與開發層面:「極高性價比」的算力替代方案
Kimi K3.1 Pro 在 Terminal-Bench 與大型代碼庫解析上逼近 Claude Opus 5.5 的表現,同時提供低廉的快取 API:
- 降本增效的非核心開發:台灣軟體團隊在進行非機密性的代碼自動化測試、3D 資產指令生成(Godot/Blender)、重構測試(Refactoring)或前端排版時,使用 K3.1 Pro 能大幅壓低 API 研發成本。
- 微調(Fine-tuning)與領域專用化:利用其 3 兆參數的強大底座(Base Model),台灣開發者可以利用在地資料集進行微調,快速開發出專屬的領域模型,而不必從頭訓練。
3. 台灣團隊的實務應對策略(Best Practices)
為了兼顧「技術先進性」與「合規資安風險」,建議台灣團隊採取「任務分級」的防護架構:
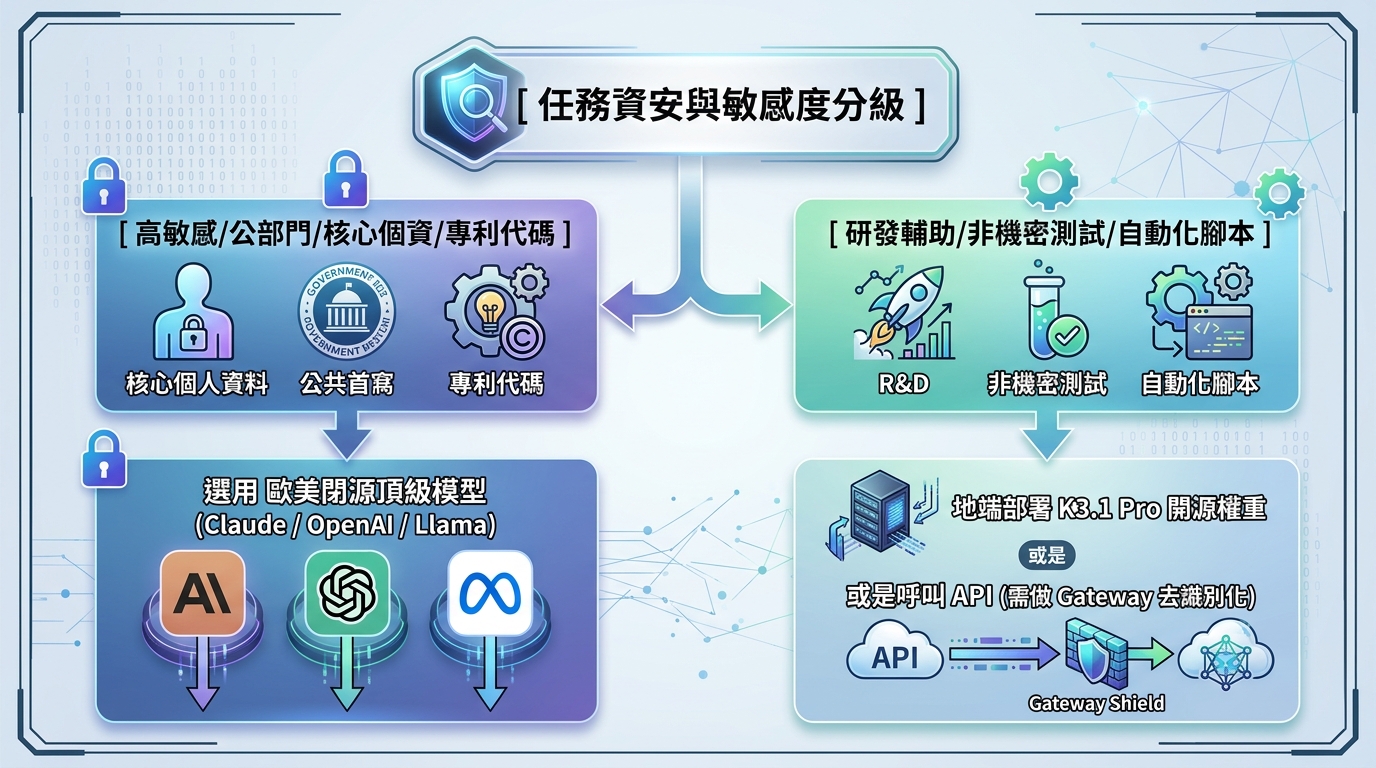
- 嚴格實施「資料去識別化(Data Anonymization)」:若直接呼叫 Kimi 官方 API,務必在上游設一道 Gateway,將程式碼中的 API Key、密碼、個資與商業機密做遮罩後再發送。
- 留意「對齊與審查機制(Alignment & Censorship)」:中國背景模型在特定歷史、政治敏感議題上通常帶有內建的拒絕回答或過濾機制。開發團隊應將 K3.1 Pro 定位於邏輯推演、Code Generation、3D 渲染與數學/金融分析等純技術性任務,避免將其用於敏感內容生成或政治人文類應用。
- 評估硬體部署成本:3 兆參數的 MoE 模型(即使單次僅激活約 1,040 億參數)對顯存(VRAM)需求極高,台灣企業地端部署時需考量硬體採購成本,或選擇量化版本(Quantized Version)運行。
結語
Kimi K3.1 Pro 的推出,證明了「巨量參數(3兆級 MoE)+長文本+高階推理 Agent」結合的可能性。它不僅在技術層面上縮短了國產模型與全球頂尖閉源模型(如 Claude Opus 5.5)之間的距離,更透過開源計畫與價格親民的 API,為全球 AI Agent 的應用生態注入了強心針。
對台灣開發者而言,「取其技術優勢,避其資安風險」是最明智的態度。將 Kimi K3.1 Pro 視為一個強大的「開源工具庫」而非「唯一依賴的平台」,利用其開源與低成本優勢作為內部開發與技術實驗的催化劑,同時保有靈活切換模型的架構設計,才是最符合台灣軟體產業利益的策略。
(責任編輯:歐敏銓)

- 月之暗面Kimi K3.1 Pro技術躍進!台灣開發者該擁抱或保持距離? - 2026/10/28
- 劃破道路的一道雷霆:Tesla Roadster如何以航太與AI黑技術重構汽車體驗 - 2026/10/19
- 常駐型AI代理時代:Meta Muse與OpenAI dots對決下的新變革 - 2026/10/05
訂閱MakerPRO知識充電報
與40000位開發者一同掌握科技創新的技術資訊!