當 NVIDIA、AMD、Intel、Google 與 Meta 等 AI 產業競爭者,開始共同投入同一套開放原始碼推論引擎 – SGLang,代表 AI 基礎設施的競爭,正從硬體算力延伸至推論軟體堆疊的主導權。
過去幾年,AI 產業的競爭焦點主要集中在模型參數規模、GPU 運算效能,以及大型模型的訓練能力。然而,隨著大型語言模型(LLM)逐漸進入企業應用,AI Agent、RAG、程式碼生成、多模態服務及地端 AI 等需求快速增加,產業開始面臨另一個更實際的問題:如何以更低的成本、更高的吞吐量,以及更好的硬體利用率,持續提供大量 AI 推論服務?
這使得 AI Inference(AI 推論)從過去相對偏向模型部署的技術環節,逐漸成為 AI 基礎設施競爭的核心戰場。SGLang 正是在這個趨勢下受到高度關注的開放原始碼專案。
它並不是另一個大型語言模型,也不是用來取代 PyTorch 的模型訓練框架,而是一套專注於高效能模型執行與服務的推論引擎。其價值在於將模型執行、記憶體管理、請求排程、平行運算及硬體最佳化整合起來,讓開發者能夠更有效率地將不同模型部署到不同運算平台。
2026 年 11 月 12 日,SGLang Consortium 正式成立,NVIDIA、AMD、Intel、Google、Meta 等企業共同加入,更讓這項技術從單一開源專案,進一步走向跨硬體、跨雲端與跨模型供應商的產業級基礎設施。這項發展值得從技術架構、產業定位與開放生態系三個層面深入觀察。
SGLang 的定位:為什麼 AI 推論需要專屬引擎?
要理解 SGLang,首先必須區分 AI 模型開發與 AI 模型服務兩個不同階段。
以 PyTorch 為例,它主要提供張量運算、自動微分、神經網路建構及模型訓練等能力,是 AI 開發者最重要的基礎框架之一。但當模型訓練完成,要將模型提供給數百、數千甚至數百萬名使用者時,問題就不再只是模型能不能運算,而是如何同時處理大量請求、有效管理 GPU 記憶體,以及降低每個 Token 的生成成本。
傳統的模型推論方式,往往是一個請求進來,就依照模型架構執行一次運算。這種方式在小規模應用尚可應付,但面對長上下文、多輪對話、Agent 工具呼叫,以及大量使用者同時連線時,GPU 很容易出現資源使用不均、記憶體浪費及等待時間增加等問題。
這也是 SGLang 的切入點。
SGLang 由 LMSYS Org 主導發展,最初的重要研究成果來自史丹佛大學與加州大學柏克萊分校等研究團隊。它的設計理念是將模型執行過程與服務端的資源管理協同最佳化(Co-design),不只追求單次推論速度,更重視整體服務的吞吐量(Throughput)、延遲(Latency)及資源利用率。
2025 年 3 月,SGLang 正式加入 PyTorch 生態系,成為 PyTorch Ecosystem 的一員。這個定位很重要:SGLang 並不是要取代 PyTorch,而是補足 PyTorch 在大規模模型服務方面的專業需求。
SGLang 的技術架構:從程式語言到 GPU Runtime 的協同最佳化
SGLang 最具特色之處,在於採取 Frontend 與 Backend 協同設計(Co-design),將模型生成程式設計與底層推論執行引擎整合,而非單純追求 GPU 運算速度。前端提供以 Python 為基礎的結構化生成語言,讓開發者能在同一套程式中定義文字生成、條件判斷、迴圈、平行呼叫及外部工具互動,適合多輪對話、RAG 與 AI Agent 等複雜工作流程;後端則負責將這些任務轉化為高效率的 GPU 運算。
其核心技術亮點包括:
-
RadixAttention: 透過 Radix Tree(基數樹)管理 KV Cache,辨識不同請求間重複的 Token Prefix,重複利用已計算的快取,減少冗餘運算,特別適合多輪對話及共享長上下文。
-
Continuous Batching: 動態調整推論批次,讓已完成的請求退出、新請求隨時加入,提高 GPU 使用率與整體吞吐量。
-
Speculative Decoding: 利用較小的 Draft Model 預測多個 Token,再由大型模型驗證,加速自回歸生成。
-
Prefill-Decode Disaggregation: 將輸入預處理與 Token 解碼分配至不同運算資源,依照工作負載特性配置 GPU,提升大型推論服務的擴展能力。
-
多元平行運算與量化: 支援 Tensor、Pipeline、Data、Expert Parallelism,以及 FP8、FP4、INT4 等量化技術,兼顧大型模型部署與運算成本。
此外,SGLang 可搭配 FlashInfer、FlashAttention、Triton 等不同 Attention Backend,依照模型架構及硬體平台選擇適合的運算核心。
整體而言,SGLang 的技術優勢不在於單一加速演算法,而是將生成流程、快取管理、請求排程與 GPU Kernel 最佳化串成完整的推論執行架構,讓複雜 AI 工作負載能以更高效率運作。
》延伸閱讀/官方技術參考: SGLang Documentation、SGLang GitHub
SGLang 的生態系:從開源專案走向跨硬體平台的共同基礎設施
SGLang 除了在技術上的重要突破,更重要的是它具備跨硬體平台的支援能力,以及與其他 AI 基礎設施的整合,讓它成為產業級的推論標準。
過去,AI 推論軟體往往與特定硬體平台高度綁定。例如,NVIDIA 有 CUDA、TensorRT-LLM 及 Triton 等技術,Intel推OpenVINO工具集已有多年,AMD 有 ROCm,Google 有 TPU 軟體堆疊。開發者即使採用相同的模型,也可能因為硬體平台不同,而需要重新調整部署環境、運算 Kernel 及記憶體管理方式。
SGLang 的發展方向則是讓推論引擎成為連接模型與異質硬體的共同軟體層。
1. 跨晶片平台:NVIDIA、AMD、Intel 與 Google 都在布局
目前 SGLang 已建立相當廣泛的硬體支援範圍,涵蓋 GPU、TPU、NPU 及 CPU 等不同運算平台。
| 硬體平台 | 代表性技術 | SGLang 生態系方向 |
|---|---|---|
| NVIDIA | CUDA、H100、Blackwell、DGX Spark | GPU Kernel、分散式推論最佳化 |
| AMD | ROCm、Instinct MI300/MI350 系列 | ROCm 推論與 GPU 最佳化 |
| Intel | Xeon、Arc/Arc Pro GPU、XPU | CPU AMX 與 GPU 推論最佳化 |
| TPU v6e、v7 | TPU 推論與分散式運算 | |
| Huawei | Ascend NPU | NPU 推論支援 |
| Moore Threads | MUSA GPU | 異質 GPU 平台支援 |
| Apple | Apple Silicon | Metal/MLX 相關執行路徑 |
這裡值得特別觀察的是,SGLang 不只是宣稱支援多種硬體,而是逐漸建立各平台的專屬最佳化路徑。
例如,AMD 透過 ROCm 提供 SGLang 的部署與推論環境,讓開發者能在 Instinct GPU 上執行開源 LLM。Intel 則針對 Xeon CPU 的 AMX 指令集,以及 Arc GPU 的 XPU 運算環境進行最佳化。
不過,硬體支援不能直接等同於功能成熟度。不同平台在模型相容性、量化格式、Kernel 效能、多 GPU 通訊及分散式推論能力上,仍存在差異。部分功能可能仍處於實驗或持續整合階段。
對企業而言,這代表 SGLang 有機會降低跨平台部署的軟體遷移成本,但並不代表只要更換 GPU,就能在不調整任何設定的情況下取得相同效能。
2. 模型生態系:從 LLM 延伸至多模態與 Diffusion
SGLang 的另一項優勢,是模型支援範圍不再侷限於傳統文字生成模型。
目前已涵蓋多個主流開源模型家族,包括:
-
大型語言模型: Llama、Qwen、DeepSeek、Gemma、Mistral、GLM 等。
-
多模態模型: 視覺語言模型(VLM),支援文字與影像等輸入。
-
Embedding 模型: 用於語意搜尋、RAG 知識檢索及向量表示。
-
Reward Model: 支援模型評估及強化學習相關工作。
-
Diffusion 模型: 透過 SGLang Diffusion 擴展至影像與影片生成。
尤其對於 Agentic AI 而言,單一 Agent 往往需要同時處理文字、圖片、文件及外部工具資訊。當這些能力逐漸整合進同一個推論基礎設施,系統管理及資源調度也有機會更加一致。
3. 與 NVIDIA Dynamo、Mooncake 等推論基礎設施整合
SGLang 的另一項發展重點,是與其他開源 AI 基礎設施整合,從單一模型推論引擎擴展為大型分散式 AI 服務架構。其中,NVIDIA Dynamo、Mooncake 與 SGLang 自身的 HiCache 最具代表性。
NVIDIA Dynamo 是面向大規模 AI 推論的分散式服務框架,可整合 SGLang 作為模型執行後端,負責請求路由、資源調度及 KV Cache 管理,協助多 GPU、多節點推論服務擴展。
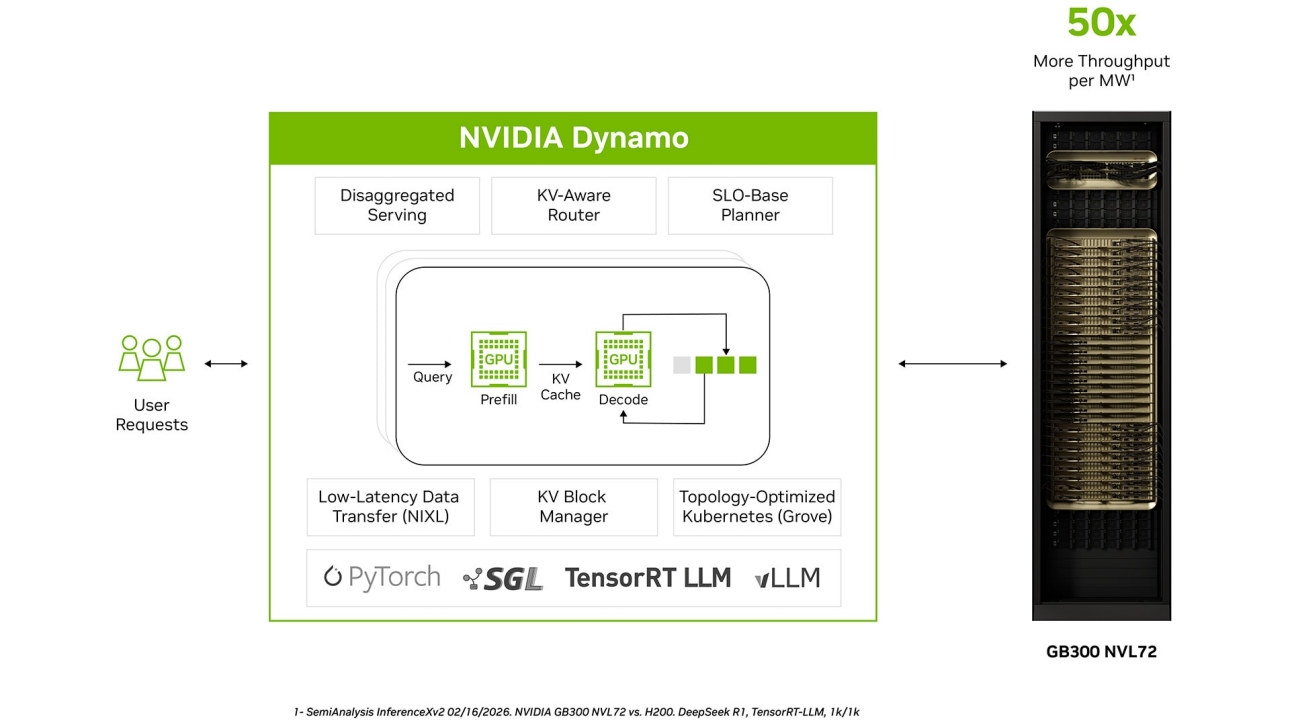
Mooncake 則專注於分散式 KV Cache 管理與傳輸,讓快取資源能跨越 GPU、主機記憶體及儲存設備共享。HiCache 是 SGLang 發展的分層快取機制,將 KV Cache 從 GPU HBM 延伸至 CPU DRAM 及外部儲存層,降低 GPU 記憶體壓力。
三者各有側重,卻能形成互補:Dynamo 負責分散式調度,Mooncake 強化快取傳輸與共享,HiCache 則改善快取分層管理。這種整合讓 SGLang 不再只是加速單一模型的推論工具,而是進一步支援長上下文、多使用者及大規模 Agent 工作負載的 AI 推論基礎設施。
4. 與強化學習(RL)及 Agentic AI 的整合
SGLang 的發展還有一個值得關注的方向:它不只是模型部署工具,也逐漸成為模型訓練與強化學習流程中的重要推論引擎。
在強化學習訓練中,模型需要反覆產生大量輸出(Rollouts),再透過 Reward Model 或環境回饋評估結果,進而更新模型參數。這個過程需要大量推論運算,因此 Rollout Generation 的效率,會直接影響整體訓練成本。SGLang 的高吞吐量推論、動態批次處理、LoRA 支援,以及模型權重更新等能力,使其適合整合進強化學習工作流程。
SGLang 的定位正在從單純的模型 Serving,延伸到 AI 模型持續訓練、評估與部署的整體生命週期。尤其當 Agentic AI 逐漸需要透過大量環境互動、工具使用及反覆推理來提升任務能力時,推論引擎的效能就不再只是影響使用者等待時間,也會直接影響 Agent 的開發與訓練成本。
SGLang Consortium 成立:AI 推論軟體開始走向跨廠商共治
2026 年 11 月 12 日,LMSYS Org 正式宣布成立 SGLang Consortium,這是 SGLang 從開源技術專案走向產業共同基礎設施的重要里程碑。
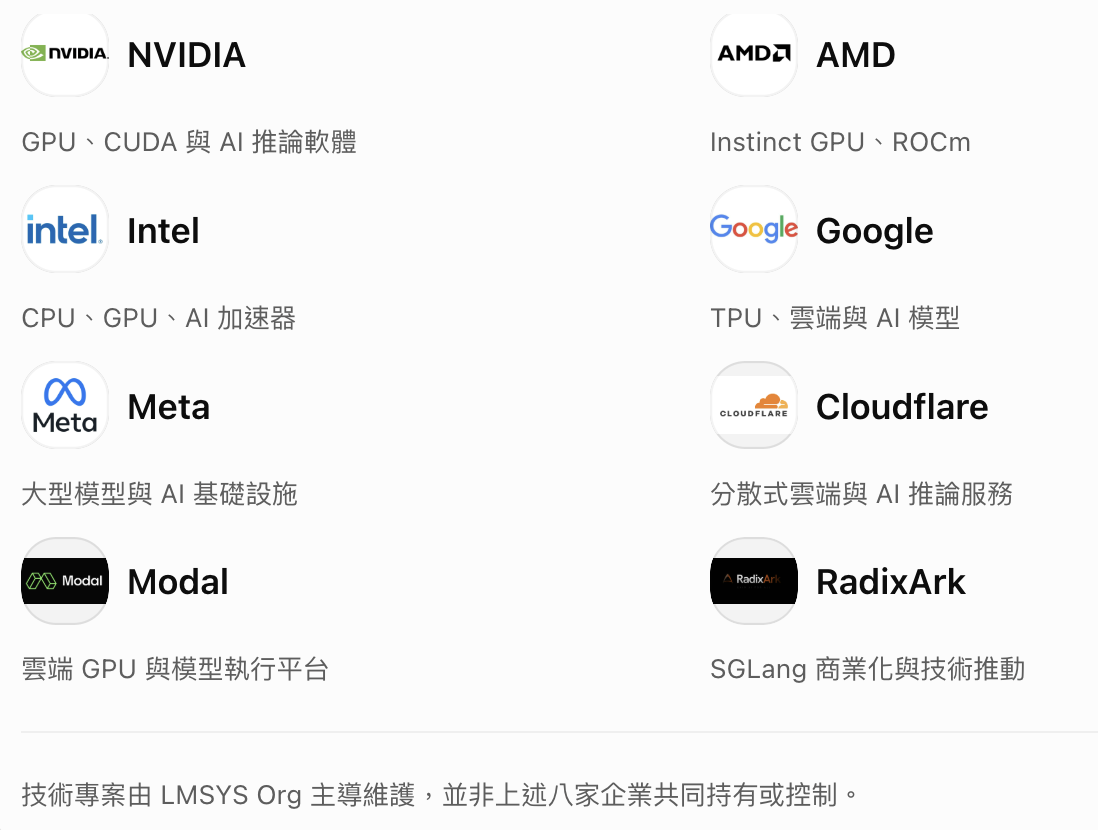
創始成員共有八家:
為什麼競爭對手願意共同投入?
這八家企業在 AI 產業的角色並不相同,但有一個共同需求:都希望 AI 推論能夠在不同硬體與服務環境中,以更低成本、更高效率執行。對 NVIDIA 而言,開放推論引擎可以擴大 CUDA 與 GPU 平台的應用範圍;對 AMD 和 Intel 而言,則有機會透過開放軟體降低開發者進入自家硬體平台的門檻。
Google、Meta 等大型模型與雲端服務業者,則能從推論效率提升中獲益,減少大規模模型服務的基礎設施成本。Cloudflare 與 Modal 等雲端服務商,則可以透過標準化的推論引擎,讓 AI 服務更容易跨平台部署及擴展。
換言之,雖然各家企業在晶片、雲端與模型市場互相競爭,但在推論軟體層卻存在高度共同利益。
Consortium 的運作方式:不是成立一個新的封閉式技術組織
值得注意的是,SGLang Consortium 並非由這些企業接管 SGLang 的原始碼或技術決策。
根據 LMSYS Org 公布的治理安排,各創始成員將指定技術代表,每年參與兩次 Roadmap 會議,針對模型支援、推論技術、硬體最佳化及分散式運算等議題提出需求與合作方向。成員可以透過工程專業、實際部署回饋、測試資源或共同開發等方式參與。
最重要的是,SGLang 的技術決策與程式碼接受權仍由專案維護者掌握,專案也持續對整個開源社群開放。這種治理模式,試圖在產業資源投入與開源社群自主性之間取得平衡,避免專案過度依賴單一企業的技術路線。
從開源產業的角度來看,這比單純獲得企業贊助更具戰略意義。它讓不同硬體供應商有機會共同參與推論軟體的技術演進,並將各自的硬體最佳化成果回饋到同一個開源專案。
對 Edge AI 與企業地端 AI 開發的意義
SGLang 的技術發展,乍看之下主要面向大型資料中心與雲端 AI 服務,但對企業地端 AI 及 Edge AI 開發者同樣具有參考價值。特別是當企業開始將 LLM、RAG 及 AI Agent 部署在內部伺服器、工作站,甚至桌上型 AI 超級電腦時,推論引擎的選擇將直接影響整體系統架構。
1. 地端 LLM:從模型能執行到服務能擴展
過去企業在地端部署 LLM,經常將重點放在 GPU 記憶體容量、模型量化及推論速度。但當地端 AI 從個人使用走向多人共享,就必須考慮請求排程、KV Cache 管理、併發數及服務穩定性。SGLang 能提供這些模型服務層面的能力,讓企業不必從頭開發一套推論管理系統。
例如,一家製造業企業在內部部署 Qwen 或 DeepSeek 模型,提供工程師、品管人員及管理部門使用,便可以透過 SGLang 建立統一的模型服務 API,再與企業 RAG、資料庫及 Agent 應用整合。
2. AI PC 與桌上型 AI 工作站:軟體相容性的重要性
隨著 DGX Spark 等桌上型 AI 運算平台出現,開發者可以在桌面環境執行過去需要資料中心才能負擔的模型開發及推論工作。SGLang 的硬體支援範圍已涵蓋 DGX Spark 等 NVIDIA 平台,讓它成為值得評估的地端模型服務方案。
不過,這並不代表所有 SGLang 的資料中心最佳化功能,都能直接在桌上型設備發揮相同效益。開發者仍須考慮統一記憶體架構、可用記憶體容量、模型量化格式及實際支援的 Kernel。
對於以單一使用者為主的桌面 AI 應用,輕量化推論 Runtime 可能已經足夠;但如果希望在同一台設備上提供多個 Agent 或多名使用者服務,SGLang 的排程與快取管理能力就更值得考慮。
3. AI Agent:推論引擎將成為 Agent Runtime 的重要基礎
AI Agent 與傳統聊天機器人最大的差異之一,是它可能需要反覆呼叫模型、查詢資料、使用工具,再依照執行結果決定下一步行動。這會帶來大量、短時間且高度重複的推論請求。例如,一個企業 AI Agent 執行設備異常分析,可能需要:
- 讀取設備感測資料。
- 查詢企業知識庫。
- 呼叫 LLM 分析異常原因。
- 使用工具取得設備歷史紀錄。
- 再次呼叫 LLM 制定處理建議。
如果同時有數百個 Agent 執行類似工作,推論系統就必須有效管理大量重複 Prompt、KV Cache 及模型請求。SGLang 的 RadixAttention、Continuous Batching 及平行執行能力,正好對應這些需求。但要釐清:SGLang 並不是完整的 Agent 開發框架,也不負責 Agent 的記憶管理、任務規劃或工具權限治理。它扮演的是 Agent 背後的高效能模型執行與服務基礎設施。
SGLang 的挑戰
儘管 SGLang 已具備相當完整的技術架構及產業支持,但要成為跨硬體平台的主流推論基礎設施,仍有幾項挑戰。
首先是硬體支援的深度與一致性。 支援某個 GPU 或 CPU 平台,不代表所有模型、量化方式及最佳化技術都能完整運作。尤其在 MoE、長上下文及多模態模型上,不同硬體的 Kernel 與通訊效能差異,仍可能非常明顯。
其次是大型推論系統的部署複雜度。 SGLang 的許多高階功能,例如 Prefill-Decode 分離、跨節點 KV Cache 傳輸及分散式平行運算,需要高速網路、適當的 GPU 配置與專業系統調校。對一般企業而言,部署門檻並不低。
第三是與其他推論框架的競爭。 vLLM 持續擴大開發者社群,TensorRT-LLM 則具有 NVIDIA 軟硬體整合優勢。未來 SGLang 必須持續在模型支援速度、推論效能、易用性及企業級穩定性方面保持競爭力。
第四是開源治理與商業利益的平衡。 當 NVIDIA、AMD、Intel 等競爭者共同參與同一個技術生態系,如何確保技術決策維持中立,以及不同硬體平台都能獲得公平的開發資源,將是 Consortium 長期運作的重要考驗。
結語
從 SGLang 的技術演進及 Consortium 的成立,可以看出 AI 基礎設施的競爭正在發生重要轉變:AI 推論的下一場競爭,是軟體與硬體的共同最佳化。
過去,產業主要透過 GPU 算力、記憶體容量及模型規模建立競爭優勢;如今,隨著推論需求快速增加,如何有效管理 GPU 資源、降低 KV Cache 成本、提高 Token 生成效率,以及讓同一套模型服務跨越不同硬體平台,逐漸成為更重要的課題。
SGLang 的價值,在於它將模型執行、推論排程、記憶體管理及硬體最佳化整合成一套開放式基礎設施。RadixAttention 解決重複前綴運算問題,Continuous Batching 提高 GPU 使用效率,Speculative Decoding 加速 Token 生成,而 Prefill-Decode 分離則為大型分散式推論提供新的架構選擇。
更重要的是,NVIDIA、AMD、Intel、Google 與 Meta 等企業共同成立 Consortium,代表推論軟體已經成為各家 AI 產業競爭者願意共同投入的關鍵領域。這並不意味著晶片廠商之間的競爭將消失,而是競爭方式正在改變:硬體廠商仍然爭奪算力市場,但也必須透過開放軟體生態系,讓自己的硬體成為開發者更容易採用、更有效率運作的選擇。
對企業及 Edge AI 開發者而言,未來選擇 AI 運算平台時,除了關注 TOPS、記憶體容量及模型效能,也應將推論引擎的成熟度、軟體相容性及生態系支持列入評估。因為在 AI 應用真正走向大規模落地的階段,決定系統經濟效益的,已不只是晶片有多快,而是整套軟硬體能否協同運作。
(責任編輯:歐敏銓)
- 【技術剖析】SGLang如何從推論引擎發展為跨平台AI服務框架? - 2026/11/16
- 【本週科技大事】AI模型、Edge AI與Robotics領域十大消息 - 2026/11/13
- 加速邊緣AI創新 Arm Flexible/Total Access方案新增Cortex-M42支援 - 2026/11/12
訂閱MakerPRO知識充電報
與40000位開發者一同掌握科技創新的技術資訊!